Votre code n'est pas le goulot d'étranglement. Votre environnement l'est.
La plupart des développeurs passent des heures à débattre :
- React contre Vue
- Docker contre Podman
- Claude Code contre Cursor
- PostgreSQL contre MySQL
Pendant ce temps, la chose avec laquelle ils interagissent tous les jours ne reçoit presque aucune attention :
Leur workspace de développement.
Il y a quelques mois, j'ai eu besoin de revenir sur un projet que je n'avais pas touché depuis presque un an.
Je me souvenais de quelques éléments :
- Il utilisait PostgreSQL.
- Redis était impliqué quelque part.
- L'application tournait dans Docker.
- Il y avait des outils IA dans le workflow.
Ce dont je ne me souvenais pas, c'était où tout ça vivait.
Le code n'était pas le problème. L'architecture n'était pas le problème.
Mon environnement de développement l'était.
Quelque part entre travailler dans des startups, construire des side projects, expérimenter avec des outils IA et gérer du travail client, ma machine s'était transformée en une collection de projets déconnectés, d'environnements dupliqués et d'infrastructure oubliée.
Chaque nouveau projet résolvait un problème immédiat. Aucun ne résolvait le problème à long terme :
Comment organiser un environnement de développement qui évolue avec sa carrière ?
Cette question m'a poussé à repenser entièrement la structure de mon workspace.
🚨 Le problème que la plupart des développeurs ignorent
Au début de nos carrières, l'organisation des projets ressemble généralement à ceci :
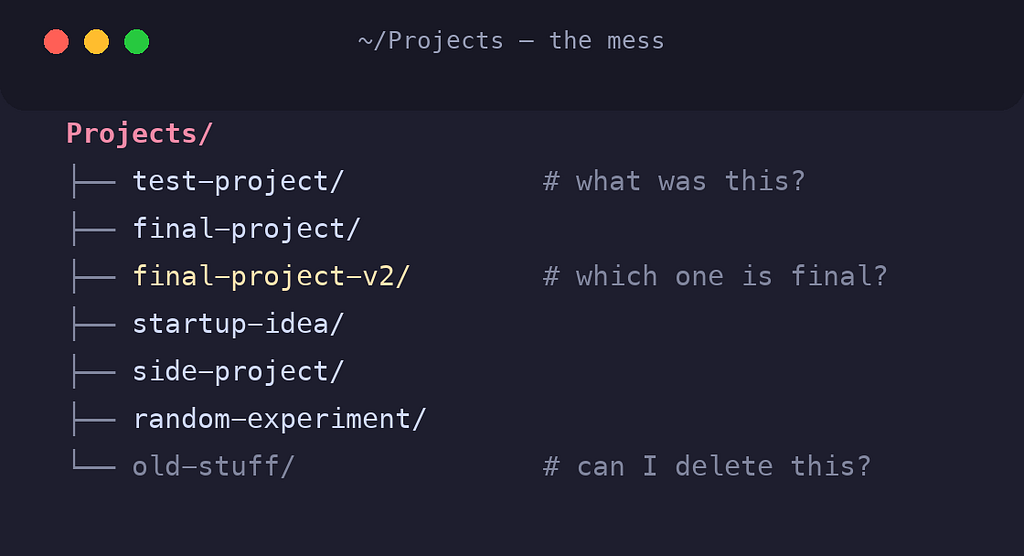
Au début, ça marche.
Puis la vie arrive.
Vous rejoignez une entreprise. Vous commencez à faire du freelance. Vous lancez une startup. Vous construisez des projets open source. Vous commencez à expérimenter avec des outils IA. Vous vous mettez à faire tourner PostgreSQL, Redis, des conteneurs Docker et des services locaux.
Le nombre de projets n'est pas le problème. Le manque de structure l'est.
À mesure que les dépôts se multiplient, la charge mentale aussi :
- Où est ce dépôt ?
- Quelle instance PostgreSQL appartient à quel projet ?
- Où est la configuration Docker ?
- Puis-je supprimer ce dossier sans risque ?
- Pourquoi ai-je trois versions différentes de Node.js installées ?
Ces questions paraissent anodines. Mais sur des années de développement, elles s'accumulent en une perte de productivité massive.
🧠 Penser comme un ingénieur systèmes
Le déclic est venu quand j'ai arrêté de traiter mon poste de travail comme une collection de projets, et que j'ai commencé à le traiter comme un système logiciel.
Je me suis posé une seule question :
À quoi ressemblerait mon environnement de développement si je devais gérer des centaines de dépôts sur la prochaine décennie ?
Cette question a complètement changé mon approche.
Au lieu d'optimiser pour les projets d'aujourd'hui, j'ai optimisé pour :
- Plusieurs employeurs
- Des ventures de startup
- Du travail client
- Des contributions open source
- Un développement Docker-first
- Un développement assisté par IA
- Une migration de machine facile
- Une maintenabilité à long terme
Le résultat est devenu ceci :
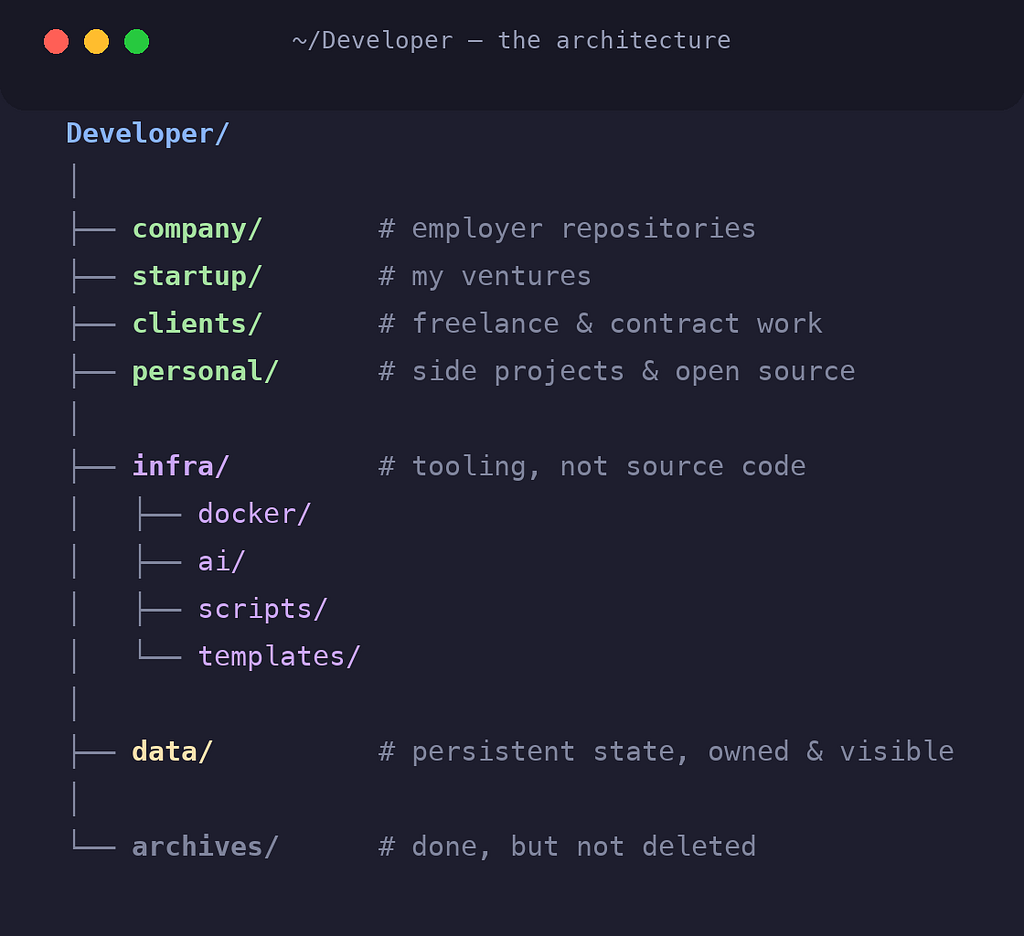
Simple. Prévisible. Évolutif.
🧱 Le code source n'est pas de l'infrastructure
L'une des plus grosses erreurs que je vois les développeurs commettre, c'est de mélanger code source et infrastructure.
Les dépôts devraient contenir :
- La logique métier
- Le code applicatif
- Les tests
- La documentation
Ils ne devraient pas devenir des décharges pour :
- Des scripts locaux
- Des expérimentations Docker
- Du stockage de base de données
- Des outils IA
- De la configuration propre à la machine
C'est pourquoi j'ai introduit une couche d'infrastructure dédiée :
infra/
├── docker/
├── ai/
├── scripts/
└── templates/
L'infrastructure évolue indépendamment des applications. Les séparer garde les dépôts propres et ciblés.
🐳 La règle Docker qui a tout simplifié
Je voulais un environnement de développement Docker-first. Mais tous les dépôts ne devraient pas être traités de la même façon.
La règle sur laquelle je me suis arrêté est étonnamment simple.
✅ Si je peux modifier le dépôt
1 Projet = 1 Environnement de développement conteneurisé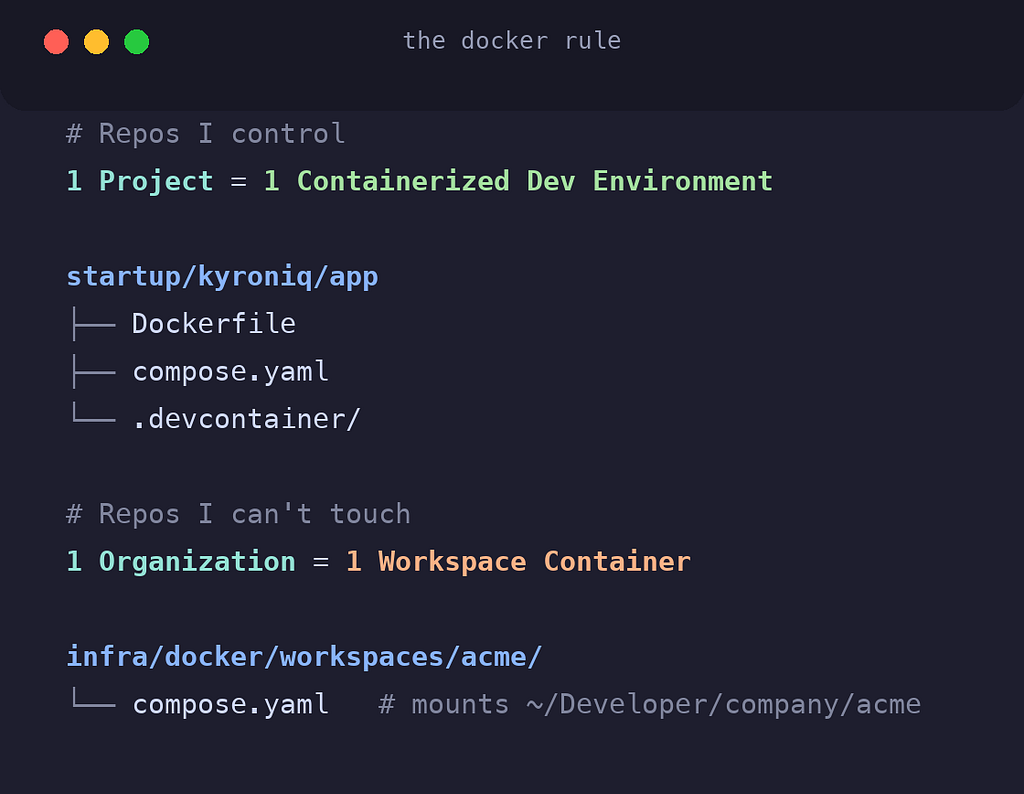
Chaque projet obtient son propre environnement isolé.
Les bénéfices :
- Isolation des dépendances
- Reproductibilité
- Onboarding facilité
- Alignement avec le CI/CD
- Meilleur support des outils IA
Le projet devient autonome. Si quelqu'un le clone demain, il obtient exactement le même environnement.
🔒 Si je ne peux pas modifier le dépôt
1 Organisation = 1 Conteneur de workspaceC'est particulièrement utile pour les dépôts d'entreprise.
Au lieu d'ajouter des fichiers Docker à des dépôts que je ne contrôle pas, je crée un conteneur de workspace externe :
infra/docker/workspaces/acme/Le workspace monte tous les dépôts appartenant à cette organisation :
volumes:
  - ~/Developer/company/acme:/workspace
Cela me permet de garder un workflow Docker-first sans toucher au code appartenant à l'entreprise.
C'est une distinction mineure, mais elle élimine beaucoup de friction.
💾 Pourquoi je sépare les données de tout le reste
C'est probablement la décision architecturale la plus importante.
La plupart des développeurs font l'une ou l'autre chose :
- Stocker les données à l'intérieur des dépôts, ou
- S'appuyer entièrement sur des volumes gérés par Docker.
Je n'aimais aucune des deux approches. À la place, j'ai créé une couche de données dédiée :
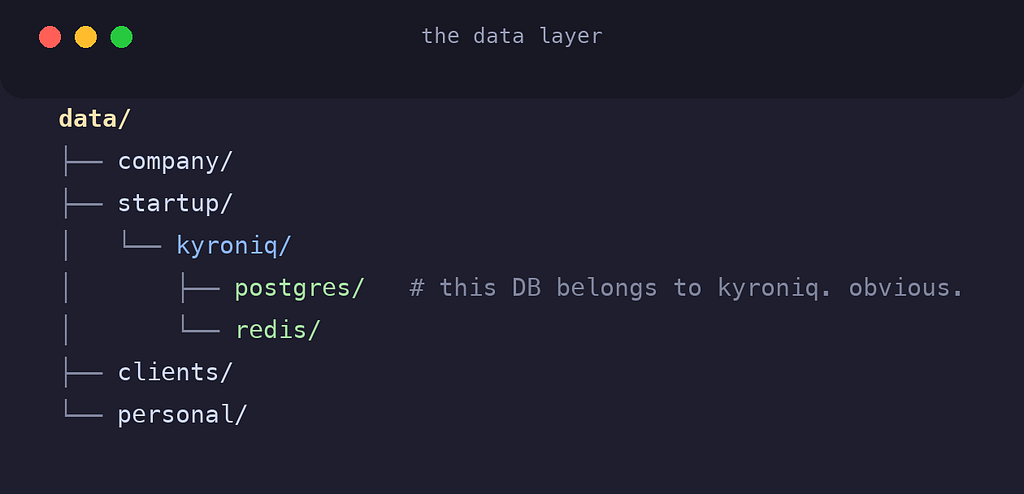
Cette structure rend la propriété évidente. Je sais immédiatement :
- Quel projet possède quelles données
- Quelle base de données appartient à quelle application
- Ce qui peut être archivé
- Ce qui a besoin d'une sauvegarde
Les bénéfices sont significatifs :
- Des dépôts plus propres
- Des sauvegardes plus simples
- Une migration simplifiée
- Des opérations Git plus rapides
- Une meilleure visibilité sur l'utilisation du stockage
Le plus important :
Je sais toujours où vivent mes données.
🤖 Construire pour un futur natif IA
La façon dont nous écrivons du logiciel change. Les outils IA font désormais partie intégrante de l'environnement de développement lui-même :
- Claude Code
- Codex
- Gemini CLI
- Des modèles locaux
- De futurs agents autonomes
La plupart des développeurs traitent encore ces outils au niveau du projet.
J'ai décidé de les traiter comme de l'infrastructure :
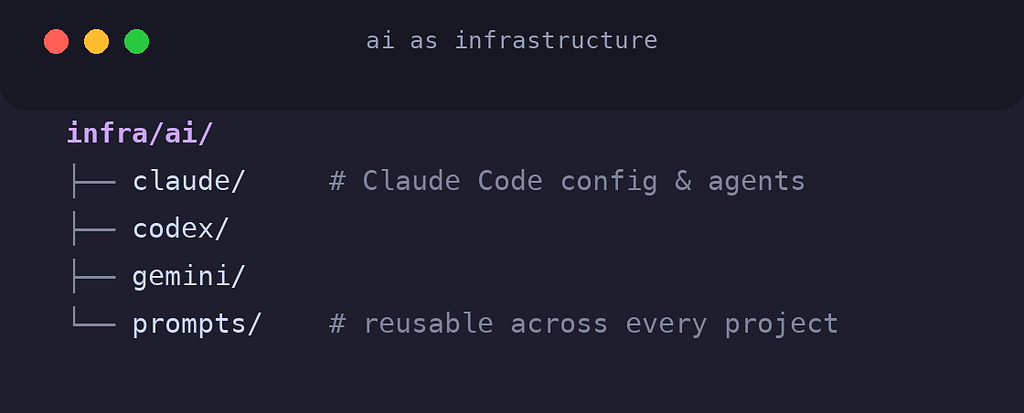
Cela crée une couche IA réutilisable qui fonctionne sur tous les projets.
À mesure que le tooling évolue, mes dépôts restent propres. La stack IA change indépendamment des applications elles-mêmes.
Cette séparation deviendra de plus en plus précieuse au fil des prochaines années.
⚡ Le plus gros gain de productivité n'était pas Docker
Ce n'était pas l'IA. Ce n'était pas l'automatisation.
C'était la réduction de la charge cognitive.
Quand chaque projet suit une structure prévisible :
company/
startup/
clients/
personal/
Je ne me pose plus de questions comme :
- Où ai-je cloné ce dépôt ?
- Quelle base de données appartient à ce projet ?
- Quelle entreprise possède ce codebase ?
- Où est la configuration Docker ?
- Puis-je archiver ceci sans risque ?
La réponse est évidente.
Et cette cohérence s'accumule. Chaque changement de contexte devient plus rapide. Chaque nouveau projet devient plus facile à intégrer. Chaque décision future devient plus simple.
📦 La migration de machine devient ennuyeuse
La plupart des développeurs ne pensent pas à la migration avant d'acheter un nouveau laptop.
Puis la douleur commence : volumes Docker. Fichiers de configuration. Scripts. Bases de données. Variables d'environnement. Personne ne se souvient où se trouve quoi.
Mon objectif était simple :
Si ma machine mourait aujourd'hui, je devrais pouvoir tout reconstruire à partir d'un seul répertoire.
Tout ce qui compte vit sous :
Developer/Dépôts. Infrastructure. Données persistantes. C'est tout.
L'environnement de développement devient portable.
Et la portabilité est l'une des fonctionnalités de productivité les plus sous-estimées dans lesquelles on puisse investir.
🎯 La vraie leçon
La structure de dossiers elle-même n'est pas ce qui compte. L'état d'esprit derrière l'est.
Les bons ingénieurs n'architecturent pas que des applications. Ils architecturent des systèmes.
Votre poste de travail est un système. Votre workflow de développement est un système. Votre productivité est un système.
Plus vous êtes intentionnel dans la conception de ces systèmes, moins vous dépensez d'énergie à lutter contre eux, et plus vous avez d'énergie pour résoudre de vrais problèmes d'ingénierie.
Un environnement de développement bien conçu ne fera pas de vous un meilleur développeur du jour au lendemain.
Mais sur des milliers d'heures de travail, il élimine discrètement la friction de chaque projet que vous touchez.
C'est de là que viennent les vrais gains de productivité.
💬 À quoi ressemble votre workspace de développement ?
Je suis toujours curieux de voir comment d'autres ingénieurs organisent leurs environnements, surtout maintenant que Docker, les Dev Containers et le développement assisté par IA font partie du workflow standard.
Le paysage des outils change chaque année.
Une bonne architecture de workspace devrait tous les traverser.