J'ai publié un article sur comment survivre aux migrations de machine. Une semaine plus tard, j'ai découvert que ma propre config avait déjà échoué, et la réparer m'a demandé du git, des symlinks, launchd, et un après-midi qui remet les pieds sur terre.
Il y a une semaine, j'ai publié un article sur l'architecture des workspaces.
La thèse était sûre d'elle :
Si ma machine mourait aujourd'hui, je devrais pouvoir tout reconstruire à partir d'un seul répertoire.
Tout sous ~/Developer/. Les dépôts. L'infrastructure. Les données. Un seul répertoire, entièrement portable.
Je me sentais plutôt fier de ça.
Puis, quelques jours plus tard, j'ai demandé à mon assistant IA de sauvegarder mon dossier de skills Claude Code dans la nouvelle structure.
Il est revenu avec quelque chose que je n'attendais pas :
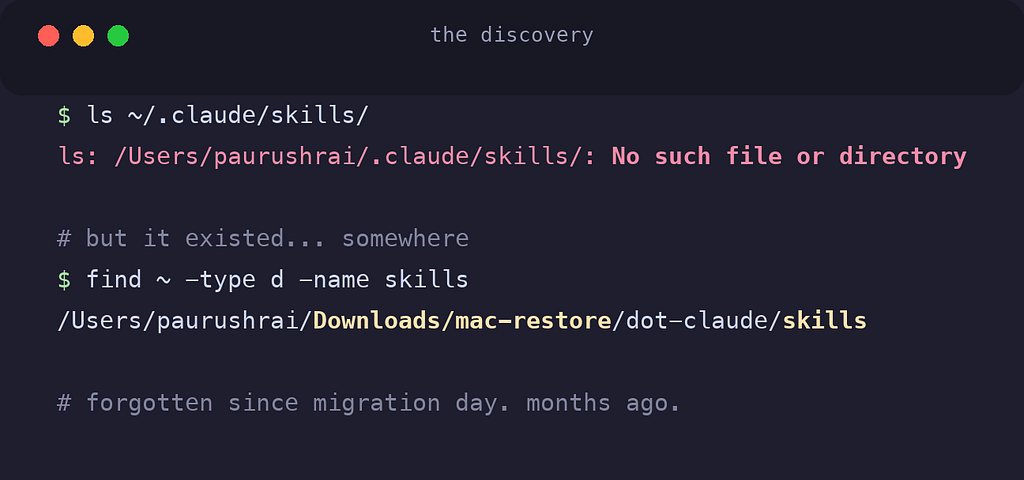
ls: /Users/paurushrai/.claude/skills/: No such file or directoryLe dossier n'existait pas.
Mais j'avais des skills. Un skill custom appelé graphify, je l'avais construit, je l'utilisais tous les jours, et ma config globale le référençait toujours. Alors où était-il ?
/Users/paurushrai/Downloads/mac-restore/dot-claude/skills/graphify/Le voilà. Dans mon dossier Downloads. À l'intérieur d'un répertoire appelé mac-restore.
Assis là depuis le jour où j'avais migré de machine. Jamais restauré. Oublié.
J'avais écrit tout un article sur exactement ce mode d'échec, et ma propre machine le vivait tranquillement depuis le début.
🔍 L'angle mort
Voici ce que j'avais raté.
Mon architecture organisait tout à l'intérieur de ~/Developer/. Mais la configuration qui fait qu'une machine se sent mienne ne vit pas là :
- L'identité et le comportement git,
~/.gitconfig - La config shell,
~/.zshrc,~/.zprofile - Les ignores globaux,
~/.gitignore_global - Les règles IA de codage,
~/.claude/CLAUDE.md - Les skills IA custom,
~/.claude/skills/ - Et le plus invisible de tous : la liste des paquets installés, qui ne vit nulle part
Tout ça éparpillé dans $HOME. Non versionné. Non sauvegardé. Invisible pour ma magnifique structure de répertoires.
Quand j'ai vérifié ~/.gitconfig pour évaluer les dégâts, c'était pire que ce que je pensais :
cat ~/.gitconfig
# → no such file
Le fichier n'existait pas. Sur l'ancienne machine, j'avais mis en place un routage d'email, un email personnel pour mes projets, un email de travail pour les dépôts d'entreprise. Rien de tout ça n'avait survécu. Je commitais depuis des mois sans le remarquer.
Le code avait migré. La configuration, non.
🔗 La plus vieille astuce d'Unix
Mon premier réflexe a été l'évidence : créer un dossier de sauvegarde, y copier les dotfiles, le pousser sur GitHub.
Mais les copies dérivent. Dès qu'il existe deux versions de .gitconfig, l'une des deux ment, et vous ne saurez pas laquelle avant que quelque chose casse.
La solution est plus vieille que moi : les symlinks.
Il n'y a qu'un seul fichier. Il vit dans le dépôt. Le répertoire home reçoit un pointeur :
~/.gitconfig  ──symlink──▶  ~/Developer/infra/dotfiles/.gitconfig
                            └── le SEUL vrai fichier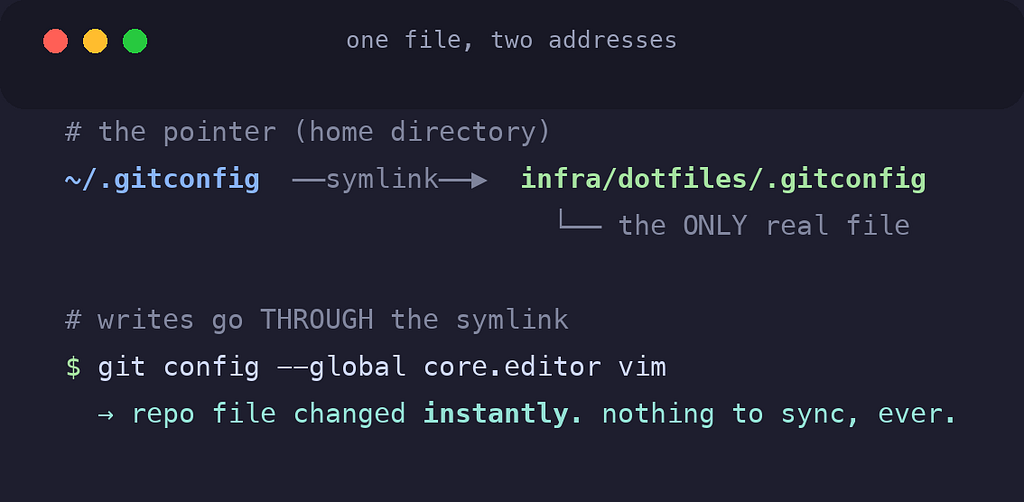
Quand je me suis demandé si ça voulait dire que j'allais devoir continuer à synchroniser les changements en retour, j'ai obtenu la réponse qui fait fonctionner toute cette conception :
Les écritures passent par le symlink.
Lancez git config --global pour changer un réglage, git suit le pointeur et écrit directement dans le fichier du dépôt. Éditez ~/.zshrc, vous éditez le fichier du dépôt. Il n'y a rien à synchroniser, parce qu'il n'y a rien à synchroniser depuis. Un fichier, deux adresses.
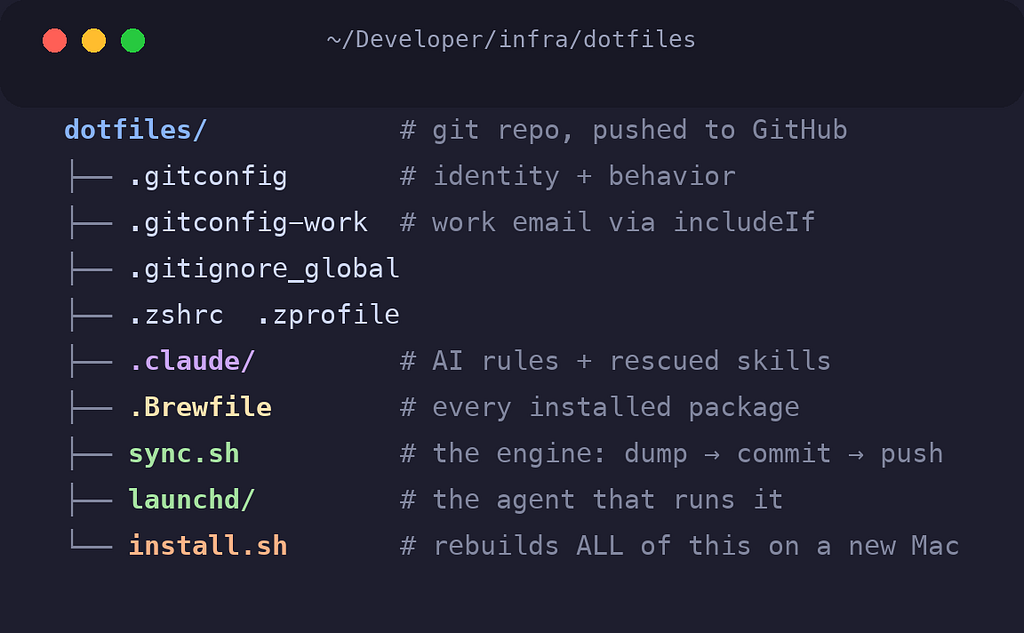
Voilà donc ce que j'ai construit. Un dépôt de dotfiles à l'intérieur de ma couche d'infrastructure, contenant les vrais fichiers, avec un install.sh idempotent qui recrée chaque symlink sur une machine neuve, en sauvegardant d'abord ce qu'il trouve, sûr à exécuter deux fois.
Config git, config shell, ignores globaux, mes règles IA, le skill graphify sauvé. Commité. Poussé. Permanent.
Une règle, apprise en examinant ce qui avait failli finir dans le dépôt : ne jamais commiter de secrets. Mon .zshrc importe maintenant un ~/.zshrc.local que git ne voit jamais. Le dépôt reçoit la structure ; la machine garde ses secrets.
Je pensais avoir fini.
🍺 Homebrew ne tient pas de journal
Puis j'ai essayé de répondre à une question simple : si cette machine mourait, qu'est-ce que je réinstallerais ?
La config git a une propriété magnifique, l'outil écrit dans son propre fichier de config, donc le dépôt connaît toujours la vérité. Homebrew n'a pas cette politesse. brew install jq installe le paquet et n'enregistre la décision nulle part. La liste des paquets n'existe qu'implicitement, comme des dossiers dans /opt/homebrew/Cellar.
Homebrew peut exporter un manifeste à la demande :
brew bundle dump --global --force
# → écrit .Brewfile : brew "gh", brew "git", brew "tree"...
J'ai donc symlinké un .Brewfile dans le dépôt comme tout le reste. Mais il y avait un hic, et ça me tracassait :
Le Brewfile ne se met à jour que quand on pense à l'exporter.
Toute ma conception reposait sur le principe que je n'y pense pas. C'est toute la raison d'être des symlinks. Un manifeste qui dépend de ma discipline est un manifeste qui aura trois mois de retard le jour où j'en aurai besoin.
🧪 Ma première tentative était fausse
La première solution semblait astucieuse : envelopper la commande brew dans une fonction shell. Intercepter chaque install et uninstall, réexporter le manifeste, auto-commiter, auto-pousser.
Je l'ai construite. Elle a marché du premier coup :
$ brew install jq
...
$ git log --oneline -1
df053cb chore(brew): install jq
Magnifique. Le message de commit nomme le paquet et tout.
Et puis j'ai regardé à nouveau et j'ai vu le trou.
Un wrapper shell ne capture que les commandes tapées dans mon shell interactif. Un script de setup qui installe des dépendances ? Invisible. Un agent IA qui lance brew dans une session ? Invisible. N'importe quel contexte qui n'est pas mon zsh avec ma config chargée ? Invisible.
J'avais automatisé l'interface alors que j'avais besoin d'automatiser l'événement.
L'installation du paquet elle-même est l'événement, et elle se produit dans le système de fichiers, pas dans mon shell.
⚙️ L'OS avait déjà la réponse
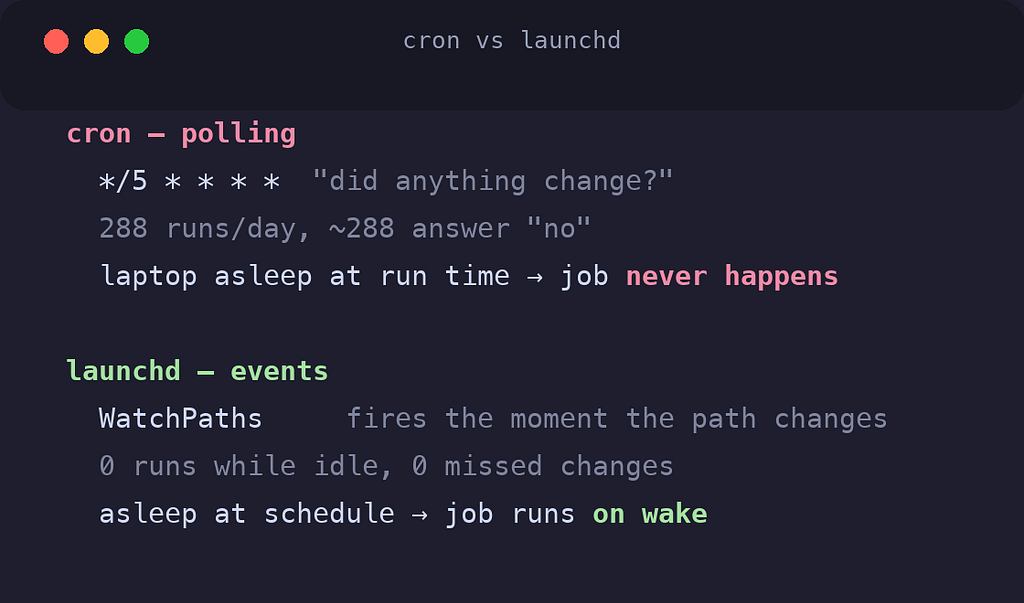
Je me suis demandé : peut-on utiliser launchd pour ça ?
launchd est le gestionnaire de services de macOS, la chose qui démarre chaque daemon du système, la réponse d'Apple à systemd. Tout développeur Mac l'a déjà vu. Presque personne n'utilise sa meilleure fonctionnalité :
WatchPaths, launchd surveille un chemin au niveau de l'OS et déclenche un job à l'instant où il change.
<key>WatchPaths</key>
<array>
    <string>/opt/homebrew/Cellar</string>
    <string>/opt/homebrew/Caskroom</string>
</array>
Maintenant peu importe qui installe le paquet, mon shell, un script, un agent, n'importe quoi. Le Cellar change, l'OS le remarque, mon script de sync se lance :
# sync.sh, tout le moteur
brew bundle dump --global --force    # instantané des paquets
git add -A                           # met en attente toute dérive de dotfile
git diff --cached --quiet && exit 0  # rien n'a changé ? on sort en silence
git commit -q -m "chore: auto-sync ${CHANGED}"
git push -q                          # hors ligne ? commite localement, pousse la prochaine fois
Plus une exécution quotidienne à midi comme filet de sécurité, et un anti-rebond de 60 secondes pour qu'installer cinq paquets produise un seul commit au lieu de cinq.
Puis le test. Installer un paquet, ne toucher à rien d'autre, observer :
$ brew install jq
... 8 secondes plus tard, zéro intervention du shell :
67ba27e chore: auto-sync .Brewfile
→ pushed to GitHub ✅
Huit secondes. La machine a documenté son propre changement, l'a commité, et l'a poussé pendant que j'étais assis là.
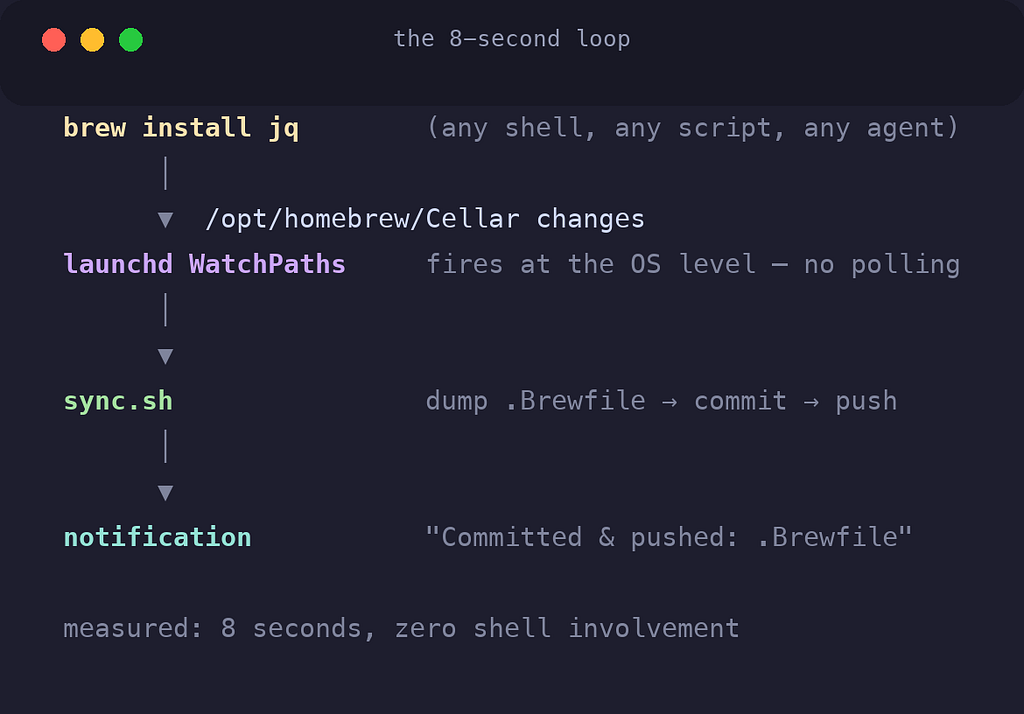
J'ai supprimé le wrapper shell dans la minute. Pas d'outils tiers, pas de polling cron sur un minuteur, pas de daemon à installer. L'OS avait fourni la réponse depuis le début.
Une fois que ça a marché pour les paquets, l'étape suivante était évidente : surveiller les dotfiles eux-mêmes. Maintenant éditer .zshrc ou mes règles IA s'auto-commit en moins d'une minute, avec le nom du fichier dans le message de commit.
🔁 Le piège que j'ai failli construire
Une décision ici va mordre quiconque construit ce système, alors elle mérite la confession.
La version paresseuse consiste à surveiller le répertoire racine du dépôt, une seule entrée de watch, couvre tout.
Mais chaque commit git modifie .git/. Surveillez la racine du dépôt et vous avez construit un ouroboros : un changement déclenche l'agent → l'agent commit → le commit change .git/ → ce qui redéclenche l'agent → à l'infini.
Alors l'agent surveille des fichiers individuels, jamais le répertoire qui contient .git. Le compromis : un fichier tout neuf dans un sous-répertoire profond n'est pas capturé instantanément, l'exécution quotidienne le rattrape. C'est documenté dans le README, et c'est un prix raisonnable.
Une automatisation qui se déclenche elle-même est le genre de bug qu'on trouve à 2h du matin.
🔔 Lui apprendre à parler
Il restait un problème, et il concernait la confiance.
L'agent commitait maintenant en mon nom, silencieusement. Un daemon silencieux est un daemon auquel on cesse de faire confiance, ou pire, qu'on oublie qu'il existe.
Le script a reçu deux lignes de notification native macOS :
osascript -e 'display notification "Committed & pushed: .Brewfile" with title "dotfiles sync"'Premier test : je ne l'ai jamais vue. Les bannières s'estompent en cinq secondes, et je regardais ailleurs.
La solution n'était pas du code, c'était un réglage. Les notifications macOS ont deux styles, et presque personne ne change le défaut : Réglages Système → Notifications → Script Editor → Alertes. Les notifications de style Alerte restent à l'écran jusqu'à ce que vous les fermiez.
Maintenant chaque sync attend dans le coin que je l'accuse réception, avec les noms des fichiers modifiés dans le message. L'historique de config de ma machine, livré sous forme de reçus.
Et il ne parle que quand quelque chose a réellement changé, une sync sans effet reste silencieuse. Une notification qu'on reçoit toutes les minutes est une notification qu'on a déjà appris à ignorer.
🎭 La question paranoïaque
Juste au moment où tout fonctionnait, j'ai pensé à la question qui casse la plupart des configurations comme celle-ci :
Que se passe-t-il quand je me connecte à GitHub avec mon compte travail ?
Je suis allé creuser, et j'ai découvert qu'« être connecté à GitHub » est en fait trois couches indépendantes que la plupart des gens n'ont jamais séparées :
Couche 1, qui a écrit le commit ? Décidé par la config git, point final. Un commit est une écriture de fichier locale ; GitHub n'est même pas contacté. Ma règle includeIf route les dépôts d'entreprise vers mon email de travail, tout le reste vers le personnel. Les connexions CLI ne peuvent pas toucher à ça.
Couche 2, qui a le droit de pousser ? Décidé par les identifiants dans le trousseau macOS. Et voici la partie fragile : le trousseau stocke les identifiants par hôte. Deux comptes, un seul github.com, la seconde connexion peut silencieusement écraser la première, et soudain mon agent de sync pousse avec la mauvaise identité et collectionne des 403.
Couche 3, pour qui agit le CLI gh ? Quel que soit le compte actif. Sans importance pour ma sync, qui parle git pur.
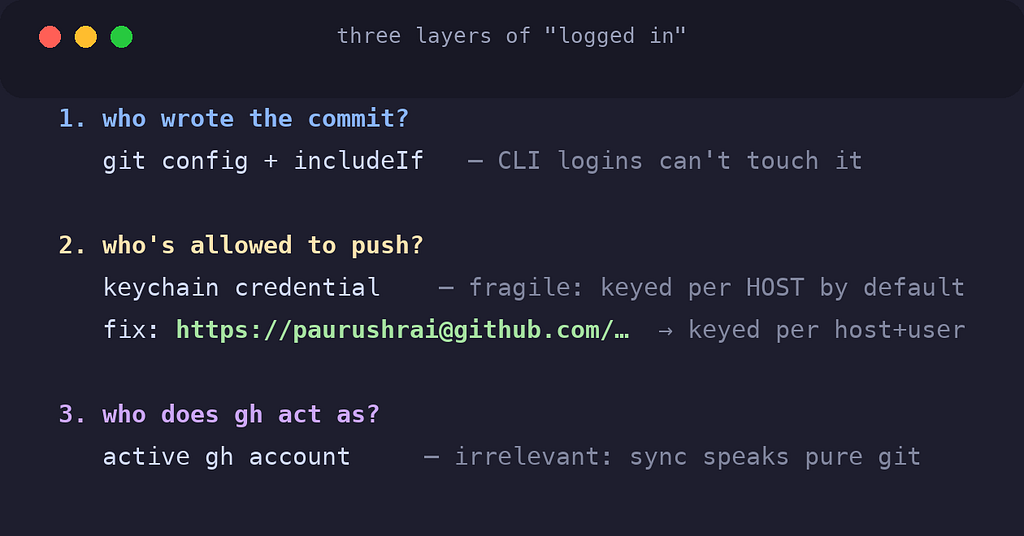
La couche 2 était la vraie exposition, et la solution tient en une ligne :
git remote set-url origin https://paurushrai@github.com/paurushrai/dotfiles.gitCe paurushrai@ n'est pas un email, c'est une syntaxe d'URL, le même user@host que ssh. Avec un nom d'utilisateur dans l'URL, le trousseau classe les identifiants sous hôte + nom d'utilisateur. Comptes séparés, tiroirs séparés, aucun écrasement possible.
Le principe est le même que celui derrière le routage d'email, et il mérite d'être formulé :
L'identité devrait être une propriété du dépôt, pas d'un état global mutable.
🚀 La machine en dix minutes
Voici où l'histoire aboutit.
La prochaine fois que je déballe un Mac, voici toute la procédure :
# 1. Homebrew, puis les deux outils d'amorçage
brew install gh git
gh auth login
# 2. Cloner la config, tout lier, réinstaller chaque paquet
gh repo clone paurushrai/dotfiles ~/Developer/infra/dotfiles
~/Developer/infra/dotfiles/install.sh
brew bundle --global# 3. Se ré-authentifier, les identifiants ne migrent jamais, par conception
claude loginEt la partie que je trouve vraiment satisfaisante : install.sh ne restaure pas seulement la config. Il amorce aussi l'agent launchd.
La nouvelle machine ne reçoit pas un instantané de ma configuration. Elle reçoit le système qui maintient ma configuration, et se met à se maintenir elle-même dès la première minute.
Ce que j'ai délibérément laissé de côté compte tout autant :
- Les identifiants, la sauvegarde d'un secret, c'est de se reconnecter. Dix secondes, par conception.
- Les caches, l'état de session, les artefacts de build, reconstruits naturellement. Les sauvegarder, c'est de l'accumulation.
- La couche de données, les volumes Postgres et Redis sont des binaires larges, vivants, mutants. Git est le mauvais outil, et copier une base de données en cours d'exécution produit des ordures corrompues. Les données ont besoin de vraies sauvegardes par instantané, ce sera le prochain article.
🎯 Ce que j'ai vraiment appris
La leçon de l'article précédent était : votre poste de travail est un système, architecturez-le.
Cette semaine m'a appris le corollaire : un système maintenu par la discipline se dégrade. Un système qui se maintient lui-même s'accumule.
Regardez la forme de chaque correctif de cette histoire :
- J'allais oublier de copier les fichiers de config → donc il n'y a qu'un fichier, symlinké, pas de copies
- J'allais oublier de mettre à jour le manifeste des paquets → donc l'OS surveille le système de fichiers
- J'allais oublier de commiter → donc l'agent commit
- J'allais rater des échecs silencieux → donc les notifications attendent que je les ferme
- J'allais oublier de tout remettre en place la prochaine fois → donc l'installeur réinstalle l'automatisation elle-même
Chacun d'eux remplace « penser à » par « ça se fait tout seul ».
Ce fichier de skill est resté mort dans mon dossier Downloads pendant des mois parce que sa restauration dépendait de mon souvenir qu'il existait. Plus rien sur ma machine ne dépend de ma mémoire.
Et honnêtement, c'est la meilleure fonctionnalité que j'aie jamais livrée à moi-même.
À quoi ressemble votre couche de config ?
Les dépôts de dotfiles sont une vieille idée. Mais la plupart s'arrêtent à « des fichiers dans un dépôt avec un script d'installation », la partie qui garde le dépôt vrai après le premier jour, c'est là que ça devient intéressant.
Le tooling continuera de changer. L'architecture devrait lui survivre.