Ich habe einen Artikel darüber veröffentlicht, wie man Rechnerwechsel übersteht. Eine Woche später stellte ich fest, dass mein eigenes Setup längst versagt hatte – und es zu reparieren kostete Git, Symlinks, launchd und einen demütigenden Nachmittag.
Vor einer Woche habe ich einen Artikel über Workspace-Architektur veröffentlicht.
Die These war selbstbewusst:
Wenn mein Rechner heute stirbt, sollte ich alles aus einem einzigen Verzeichnis wiederherstellen können.
Alles unter ~/Developer/. Repositories. Infrastruktur. Daten. Ein Verzeichnis, vollständig portabel.
Ich fühlte mich ziemlich gut dabei.
Dann, ein paar Tage später, bat ich meinen KI-Assistenten, meinen Claude-Code-Skills-Ordner in die neue Struktur zu sichern.
Er kam mit etwas zurück, das ich nicht erwartet hatte:
ls: /Users/paurushrai/.claude/skills/: No such file or directoryDer Ordner existierte nicht.
Aber ich hatte Skills. Einen selbstgebauten namens graphify – ich hatte ihn gebaut, täglich genutzt, und meine globale Konfiguration verwies noch darauf. Wo war er also?
/Users/paurushrai/Downloads/mac-restore/dot-claude/skills/graphify/Da war er. In meinem Downloads-Ordner. In einem Verzeichnis namens mac-restore.
Lag dort seit dem Tag, an dem ich Rechner gewechselt hatte. Nie wiederhergestellt. Vergessen.
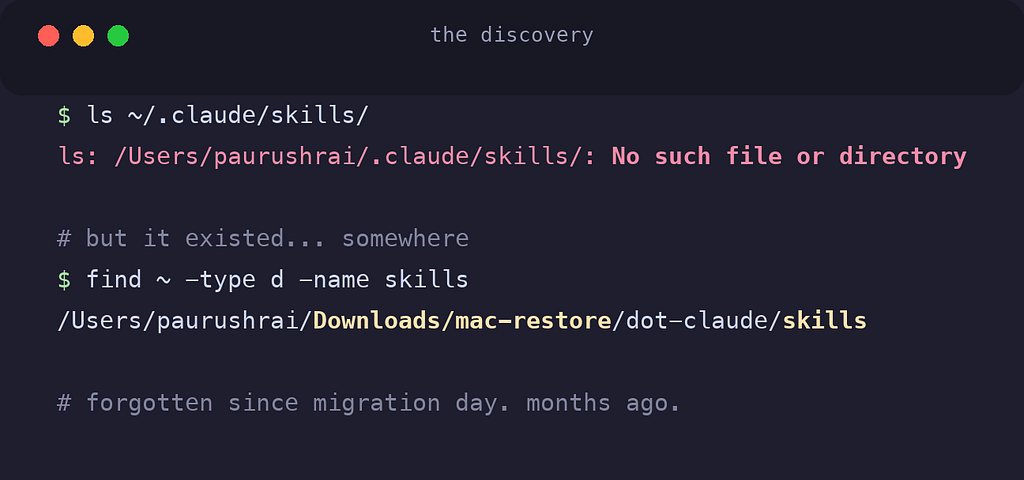
Ich hatte einen ganzen Artikel über genau dieses Fehlermuster geschrieben – und mein eigener Rechner lebte es die ganze Zeit still vor sich hin.
🔍 Der blinde Fleck
Hier ist, was mir entgangen war.
Meine Architektur organisierte alles innerhalb von ~/Developer/. Aber die Konfiguration, die einen Rechner wie meinen anfühlen lässt, lebt nicht dort:
- Git-Identität und -Verhalten,
~/.gitconfig - Shell-Setup,
~/.zshrc,~/.zprofile - Globale Ignores,
~/.gitignore_global - KI-Coding-Regeln,
~/.claude/CLAUDE.md - Eigene KI-Skills,
~/.claude/skills/ - Und der unsichtbarste von allen: die Liste installierter Pakete, die nirgendwo lebt
Alles verstreut über $HOME. Nicht versioniert. Nicht gesichert. Unsichtbar für meine wunderschöne Verzeichnisstruktur.
Als ich ~/.gitconfig prüfte, um den Schaden abzuschätzen, war es schlimmer als gedacht:
cat ~/.gitconfig
# → no such file
Die Datei existierte nicht. Auf dem alten Rechner hatte ich E-Mail-Routing eingerichtet – private E-Mail für meine Projekte, Arbeits-E-Mail für Firmen-Repos. Nichts davon hatte überlebt. Ich hatte monatelang committet, ohne es zu bemerken.
Der Code war migriert. Die Konfiguration nicht.
🔗 Der älteste Trick in Unix
Mein erster Instinkt war der naheliegende: einen Backup-Ordner anlegen, die Dotfiles hineinkopieren, auf GitHub pushen.
Aber Kopien driften auseinander. In dem Moment, in dem es zwei Versionen von .gitconfig gibt, ist eine davon eine Lüge – und man weiß erst, welche, wenn etwas kaputtgeht.
Der Fix ist älter als ich: Symlinks.
Es gibt nur eine Datei. Sie lebt im Repo. Das Home-Verzeichnis bekommt einen Zeiger:
~/.gitconfig  ──symlink──▶  ~/Developer/infra/dotfiles/.gitconfig
                            └── the ONLY real file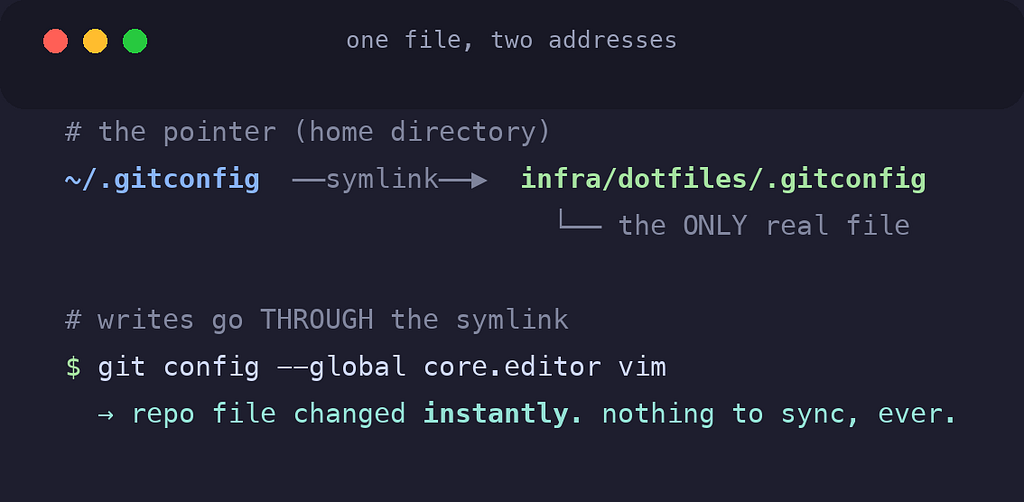
Als ich fragte, ob das bedeutet, dass ich Änderungen ständig zurücksynchronisieren muss, bekam ich die Antwort, die dieses ganze Design zum Funktionieren bringt:
Schreibvorgänge gehen durch den Symlink.
git config --global ausführen, um eine Einstellung zu ändern – Git folgt dem Zeiger und schreibt direkt in die Repo-Datei. ~/.zshrc bearbeiten – man bearbeitet die Repo-Datei. Es gibt nichts zu synchronisieren, weil es nichts gibt, wovon aus synchronisiert werden müsste. Eine Datei, zwei Adressen.
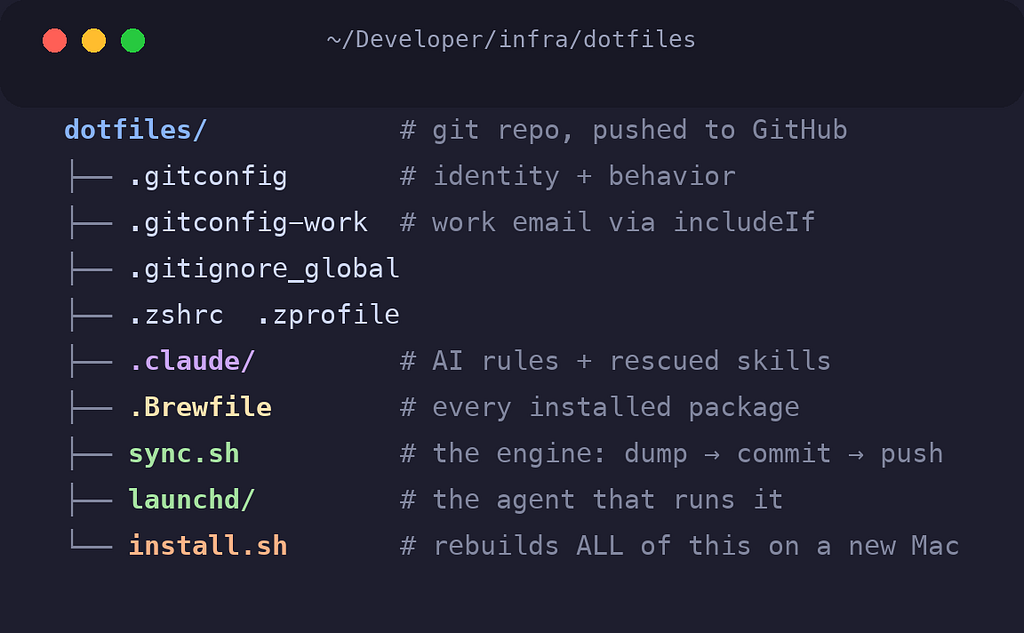
Also habe ich genau das gebaut. Ein Dotfiles-Repo innerhalb meiner Infrastruktur-Schicht, das die echten Dateien enthält, mit einem idempotenten install.sh, das jeden Symlink auf einem frischen Rechner neu anlegt – wobei zunächst alles Vorgefundene gesichert wird, sicher, es zweimal auszuführen.
Git-Config, Shell-Config, globale Ignores, meine KI-Regeln, der gerettete graphify-Skill. Committed. Gepusht. Dauerhaft.
Eine Regel, gelernt beim Prüfen dessen, was fast ins Repo gelangt wäre: niemals Secrets committen. Meine .zshrc bindet jetzt eine ~/.zshrc.local ein, die Git nie zu Gesicht bekommt. Das Repo bekommt die Struktur; der Rechner behält seine Geheimnisse.
Ich dachte, ich wäre fertig.
🍺 Homebrew führt kein Tagebuch
Dann versuchte ich, eine einfache Frage zu beantworten: Wenn dieser Rechner heute stirbt, was müsste ich neu installieren?
Git-Config hat eine schöne Eigenschaft – das Tool schreibt in seine eigene Konfigurationsdatei, also kennt das Repo immer die Wahrheit. Homebrew hat keine solchen Manieren. brew install jq installiert das Paket und protokolliert die Entscheidung nirgendwo. Die Paketliste existiert nur implizit, als Ordner in /opt/homebrew/Cellar.
Homebrew kann auf Anfrage ein Manifest ausgeben:
brew bundle dump --global --force
# → writes .Brewfile: brew "gh", brew "git", brew "tree"...
Also habe ich eine .Brewfile wie alles andere ins Repo symlinked. Aber es gab einen Haken, der mich nicht losließ:
Das Brewfile aktualisiert sich nur, wenn man daran denkt, es auszugeben.
Mein ganzes Design basierte auf der Prämisse, dass ich mich nicht erinnere. Das ist der ganze Grund, warum die Symlinks existieren. Ein Manifest, das von meiner Disziplin abhängt, ist ein Manifest, das drei Monate veraltet ist, wenn ich es brauche.
🧪 Mein erster Versuch war falsch
Die erste Lösung fühlte sich clever an: den brew-Befehl in eine Shell-Funktion einwickeln. Jede Installation und Deinstallation abfangen, das Manifest neu ausgeben, automatisch committen, automatisch pushen.
Ich habe es gebaut. Es funktionierte beim ersten Versuch:
$ brew install jq
...
$ git log --oneline -1
df053cb chore(brew): install jq
Wunderschön. Die Commit-Message nennt sogar das Paket.
Und dann habe ich es mir noch einmal angesehen und das Loch entdeckt.
Ein Shell-Wrapper fängt nur Befehle ab, die in meine interaktive Shell getippt werden. Ein Setup-Skript, das Abhängigkeiten installiert? Unsichtbar. Ein KI-Agent, der brew innerhalb einer Session ausführt? Unsichtbar. Jeder Kontext, der nicht meine zsh mit meiner geladenen Konfiguration ist? Unsichtbar.
Ich hatte die Schnittstelle automatisiert, obwohl ich das Ereignis hätte automatisieren müssen.
Die Paketinstallation selbst ist das Ereignis – und es passiert im Dateisystem, nicht in meiner Shell.
⚙️ Das Betriebssystem hatte die Antwort schon
Ich fragte: Können wir dafür launchd verwenden?
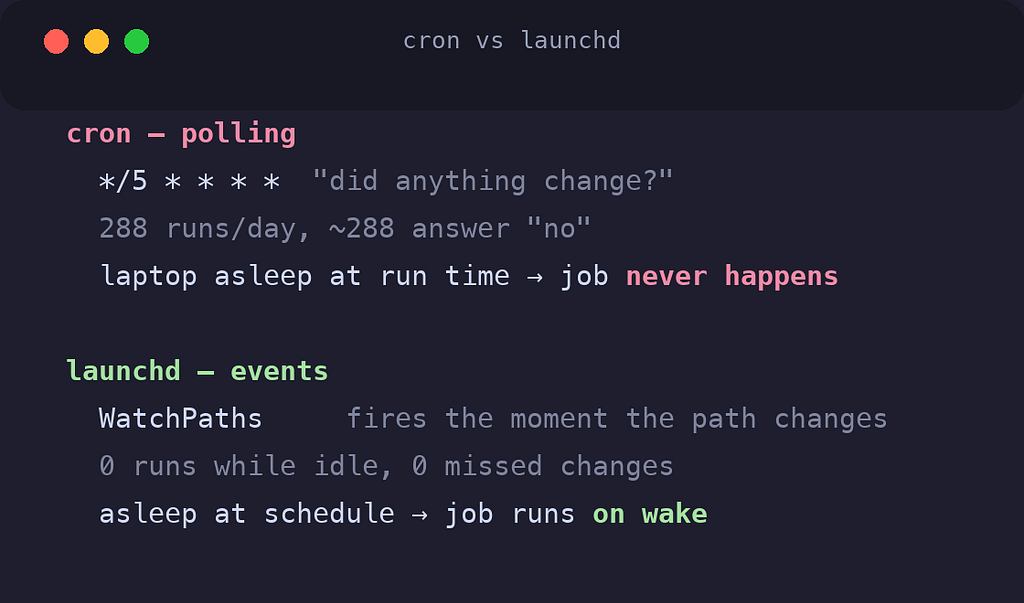
launchd ist der Service-Manager von macOS – das Ding, das jeden Daemon im System startet, Apples Antwort auf systemd. Jeder Mac-Entwickler hat es schon gesehen. Fast niemand nutzt sein bestes Feature:
WatchPaths, launchd beobachtet einen Pfad auf Betriebssystemebene und feuert einen Job, sobald er sich ändert.
<key>WatchPaths</key>
<array>
    <string>/opt/homebrew/Cellar</string>
    <string>/opt/homebrew/Caskroom</string>
</array>
Jetzt spielt es keine Rolle mehr, wer das Paket installiert – meine Shell, ein Skript, ein Agent, egal was. Der Cellar ändert sich, das Betriebssystem bemerkt es, mein Sync-Skript läuft:
# sync.sh, the whole engine
brew bundle dump --global --force    # snapshot packages
git add -A                           # stage any dotfile drift
git diff --cached --quiet && exit 0  # nothing changed? exit silently
git commit -q -m "chore: auto-sync ${CHANGED}"
git push -q                          # offline? commits locally, pushes next time
Dazu ein täglicher Lauf um Mittag als Auffangnetz und ein 60-Sekunden-Throttle, damit die Installation von fünf Paketen einen Commit statt fünf erzeugt.
Dann der Test. Ein Paket installieren, sonst nichts anfassen, zusehen:
$ brew install jq
... 8 seconds later, zero shell involvement:
67ba27e chore: auto-sync .Brewfile
→ pushed to GitHub ✅
Acht Sekunden. Der Rechner dokumentierte seine eigene Änderung, committete sie und pushte sie, während ich dasaß.
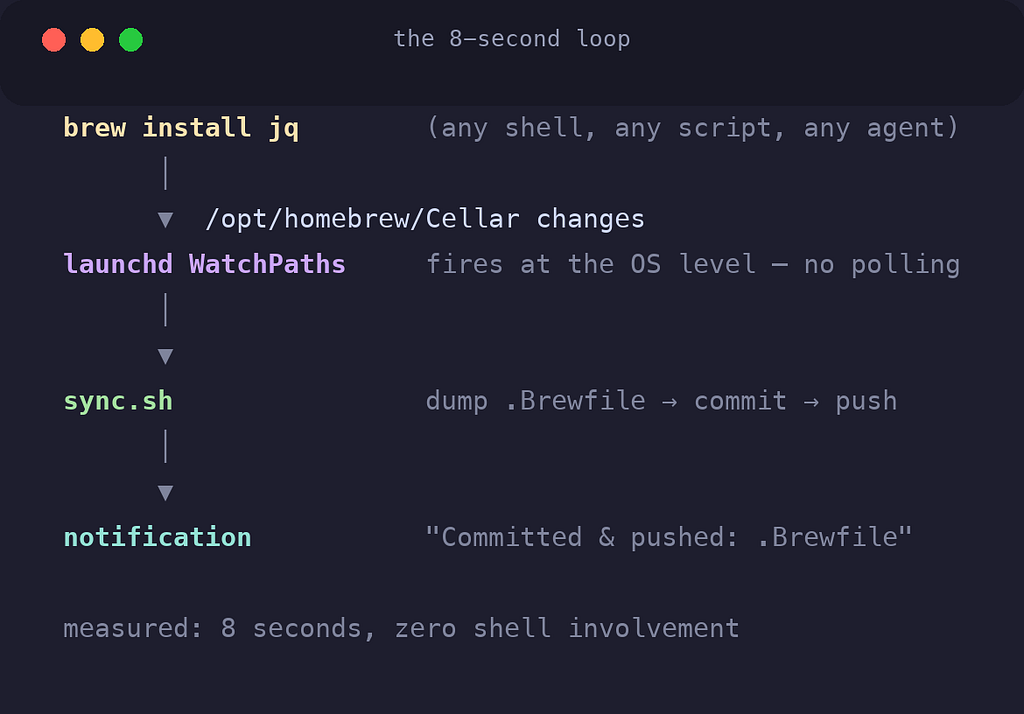
Ich habe den Shell-Wrapper in derselben Minute gelöscht. Keine Drittanbieter-Tools, kein Cron-Polling im Takt, kein zu installierender Daemon. Das Betriebssystem hatte die Antwort schon immer mitgeliefert.
Sobald das für Pakete funktionierte, war der nächste Schritt naheliegend: die Dotfiles selbst beobachten. Jetzt committet das Bearbeiten von .zshrc oder meinen KI-Regeln automatisch innerhalb einer Minute, mit dem Dateinamen in der Commit-Message.
🔁 Die Falle, die ich fast gebaut hätte
Eine Entscheidung hier wird jeden beißen, der das nachbaut, also ist es das Geständnis wert.
Die faule Version ist, das Wurzelverzeichnis des Repos zu beobachten – ein einziger Watch-Eintrag deckt alles ab.
Aber jeder Git-Commit verändert .git/. Beobachtet man das Repo-Wurzelverzeichnis, hat man einen Ouroboros gebaut: Änderung feuert den Agenten → Agent committet → der Commit ändert .git/ → das feuert den Agenten → für immer.
Also beobachtet der Agent einzelne Dateien, nie das Verzeichnis, das .git enthält. Der Kompromiss: Eine brandneue Datei in einem tiefen Unterverzeichnis wird nicht sofort erfasst – der tägliche Lauf sammelt sie stattdessen ein. Das steht in der README, und es ist ein fairer Preis.
Automatisierung, die sich selbst auslöst, ist genau der Fehlertyp, den man um 2 Uhr nachts findet.
🔔 Ihm das Sprechen beibringen
Es blieb noch ein Problem, und es ging um Vertrauen.
Der Agent committete jetzt in meinem Namen, still. Ein stiller Daemon ist ein Daemon, dem man nicht mehr traut – oder schlimmer, den man vergisst.
Das Skript bekam zwei Zeilen native macOS-Benachrichtigung:
osascript -e 'display notification "Committed & pushed: .Brewfile" with title "dotfiles sync"'Erster Test: Ich habe sie nie gesehen. Banner verblassen nach fünf Sekunden, und ich schaute woandershin.
Der Fix war kein Code – es war eine einzige Einstellung. macOS-Benachrichtigungen haben zwei Stile, und fast niemand ändert die Vorgabe: Systemeinstellungen → Mitteilungen → Script Editor → Warnungen. Warnungs-Benachrichtigungen bleiben auf dem Bildschirm, bis man sie abweist.
Jetzt wartet jeder Sync in der Ecke darauf, dass ich ihn zur Kenntnis nehme, mit den geänderten Dateinamen in der Nachricht. Die Konfigurationshistorie meines Rechners, geliefert als Quittungen.
Und es spricht nur, wenn sich tatsächlich etwas geändert hat – ein No-Op-Sync bleibt still. Eine Benachrichtigung, die jede Minute kommt, ist eine, die man schon gelernt hat zu ignorieren.
🎭 Die paranoide Frage
Gerade als alles funktionierte, kam mir die Frage, die die meisten Setups wie dieses zerstört:
Was passiert, wenn ich mich mit meinem Arbeits-Account bei GitHub einlogge?
Ich habe nachgeforscht und festgestellt, dass "bei GitHub eingeloggt" tatsächlich drei unabhängige Schichten sind, die die meisten Leute nie getrennt haben:
Schicht 1, Wer hat den Commit geschrieben? Entschieden von der Git-Konfiguration, Punkt. Ein Commit ist ein lokaler Dateischreibvorgang; GitHub wird nicht einmal kontaktiert. Meine includeIf-Regel routet Firmen-Repos zu meiner Arbeits-E-Mail, alles andere zu privat. CLI-Logins können das nicht berühren.
Schicht 2, Wer darf pushen? Entschieden von den Anmeldedaten in der macOS-Schlüsselbund. Und hier ist der fragile Teil: Der Schlüsselbund speichert Anmeldedaten pro Host. Zwei Accounts, ein github.com – der zweite Login kann den ersten still überschreiben, und plötzlich pusht mein Sync-Agent mit der falschen Identität und sammelt 403er ein.
Schicht 3, Als wer agiert die gh-CLI? Was auch immer der aktive Account ist. Irrelevant für meinen Sync, der reines Git spricht.
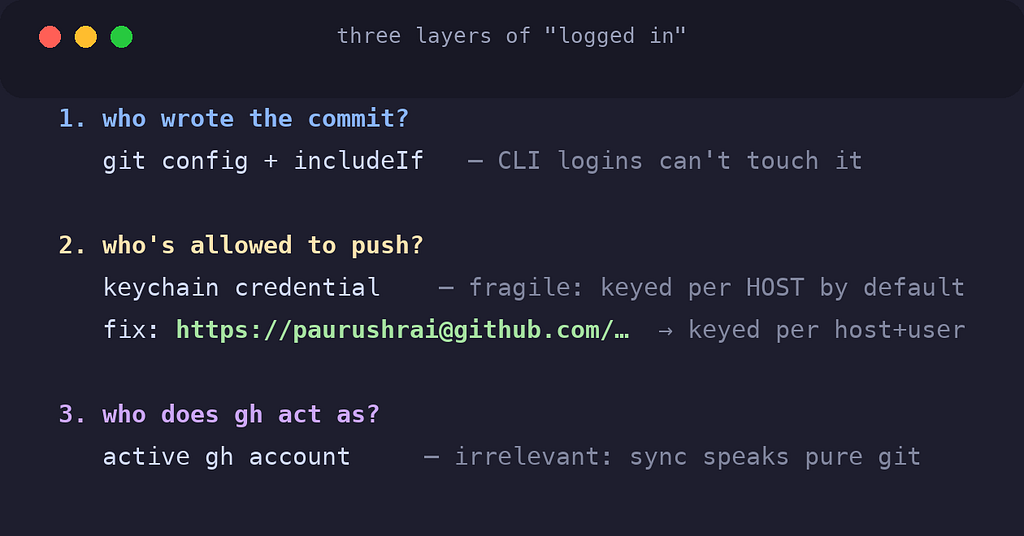
Schicht 2 war die eigentliche Schwachstelle, und der Fix ist eine einzige Zeile:
git remote set-url origin https://paurushrai@github.com/paurushrai/dotfiles.gitDas paurushrai@ ist keine E-Mail – es ist URL-Syntax, dasselbe user@host wie bei ssh. Mit einem Benutzernamen in der URL speichert der Schlüsselbund Anmeldedaten unter Host + Benutzername. Getrennte Accounts, getrennte Schubladen, keine Überschreibungen möglich.
Das Prinzip ist dasselbe wie hinter dem E-Mail-Routing, und es lohnt sich, es so zu formulieren:
Identität sollte eine Eigenschaft des Repos sein, nicht des globalen veränderlichen Zustands.
🚀 Der Zehn-Minuten-Rechner
Hier landet die Geschichte.
Beim nächsten Mal, wenn ich einen Mac auspacke, ist das die gesamte Prozedur:
# 1. Homebrew, then the two bootstrap tools
brew install gh git
gh auth login
# 2. Clone the config, link everything, reinstall every package
gh repo clone paurushrai/dotfiles ~/Developer/infra/dotfiles
~/Developer/infra/dotfiles/install.sh
brew bundle --global# 3. Re-authenticate, credentials never migrate, by design
claude loginUnd der Teil, den ich wirklich befriedigend finde: install.sh stellt nicht nur die Konfiguration wieder her. Es bootstrapt auch den launchd-Agenten.
Der neue Rechner bekommt keinen Schnappschuss meines Setups. Er bekommt das System, das mein Setup pflegt – und beginnt ab Minute eins, sich selbst zu pflegen.
Was ich bewusst weggelassen habe, zählt genauso:
- Anmeldedaten, das Backup für ein Geheimnis ist, sich erneut einzuloggen. Zehn Sekunden, mit Absicht.
- Caches, Session-Zustand, Build-Artefakte, werden auf natürliche Weise neu erzeugt. Sie zu sichern wäre Horten.
- Die Datenschicht, Postgres- und Redis-Volumes sind große, lebendige, sich verändernde Binärdaten. Git ist das falsche Werkzeug, und eine laufende Datenbank zu kopieren erzeugt korrupten Müll. Daten brauchen echte Snapshot-Backups, das ist der nächste Artikel.
🎯 Was ich wirklich gelernt habe
Die Lektion des vorherigen Artikels war: dein Arbeitsplatz ist ein System, architektiere ihn.
Diese Woche hat mir das Korollar beigebracht: Ein System, das durch Disziplin gepflegt wird, verfällt. Ein System, das sich selbst pflegt, verstärkt sich.
Sieh dir die Form jeder Lösung in dieser Geschichte an:
- Ich würde vergessen, Konfigurationsdateien zu kopieren → also gibt es eine Datei, symlinked, keine Kopien
- Ich würde vergessen, das Paket-Manifest zu aktualisieren → also beobachtet das Betriebssystem das Dateisystem
- Ich würde vergessen zu committen → also committet der Agent
- Ich würde stille Fehler übersehen → also warten Benachrichtigungen, bis ich sie abweise
- Ich würde vergessen, das alles nächstes Mal wieder einzurichten → also installiert der Installer die Automatisierung selbst neu
Jede einzelne ersetzt "daran denken" durch "es passiert einfach".
Diese Skill-Datei lag monatelang tot in meinem Downloads-Ordner, weil ihre Wiederherstellung davon abhing, dass ich mich an ihre Existenz erinnerte. Nichts auf meinem Rechner hängt mehr von meinem Gedächtnis ab.
Und ehrlich gesagt, das ist das beste Feature, das ich je für mich selbst ausgeliefert habe.
Wie sieht deine Konfigurationsschicht aus?
Dotfiles-Repos sind eine alte Idee. Aber die meisten hören bei "Dateien in einem Repo mit Install-Skript" auf, der Teil, der das Repo nach Tag eins wahr hält, ist da, wo es interessant wird.
Das Tooling wird sich weiter ändern. Die Architektur sollte es überleben.