你的代码不是瓶颈。你的环境才是。
大多数开发者会花上几个小时争论:
- React 还是 Vue
- Docker 还是 Podman
- Claude Code 还是 Cursor
- PostgreSQL 还是 MySQL
与此同时,那个他们每一天都要打交道的东西,却几乎无人问津:
他们的开发工作区。
几个月前,我需要重新捡起一个将近一年没碰过的项目。
我还记得几件事:
- 它用了 PostgreSQL。
- Redis 也参与其中。
- 应用跑在 Docker 里。
- 工作流里有 AI 工具。
我不记得的,是这些东西究竟都住在哪里。
代码不是问题。架构也不是问题。
我的开发环境才是问题。
在辗转于创业公司、折腾业余项目、试验 AI 工具、还要兼顾客户工作的过程中,我的机器不知不觉变成了一堆互不相连的项目、重复的环境,和被遗忘的基础设施的集合。
每个新项目都解决了眼前的问题。没有一个解决长期的问题:
你要怎么组织一个能随你的职业生涯一起扩展的开发环境?
正是这个问题,让我彻底重新设计了自己的工作区结构。
🚨 大多数开发者都在忽视的问题
职业生涯早期,项目组织通常是这个样子:
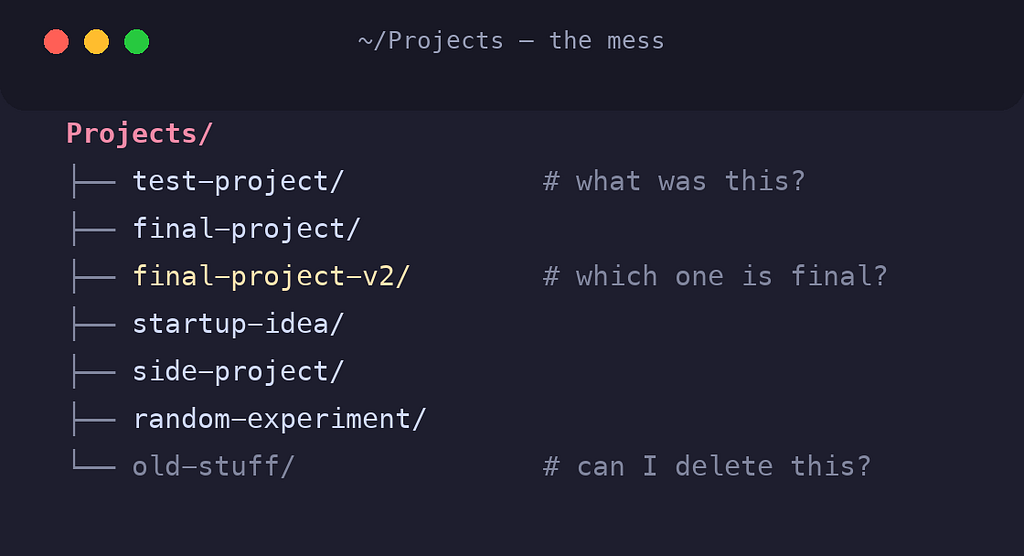
一开始,它是能用的。
然后生活开始发生。
你入职了一家公司。你开始接自由职业。你启动了一家创业公司。你搭建开源项目。你开始试验 AI 工具。你开始跑 PostgreSQL、Redis、Docker 容器和本地服务。
项目数量不是问题。缺乏结构才是。
随着仓库越来越多,心智负担也在增加:
- 那个仓库在哪儿?
- 哪个 PostgreSQL 实例属于哪个项目?
- Docker 配置在哪儿?
- 这个文件夹能不能安全删掉?
- 我为什么装了三个不同版本的 Node.js?
这些问题听上去都很小。但经年累月下来,它们会叠加成一场巨大的生产力损耗。
🧠 像系统工程师一样思考
真正的突破发生在我不再把自己的工作站当成一堆项目的集合,而是开始把它当成一个软件系统的时候。
我问了自己一个问题:
如果接下来十年我要管理数百个仓库,我的开发环境应该是什么样子?
这个问题彻底改变了我的思路。
我不再为今天的项目做优化,而是为以下这些做优化:
- 多个雇主
- 创业项目
- 客户工作
- 开源贡献
- Docker 优先的开发方式
- AI 辅助开发
- 轻松的机器迁移
- 长期可维护性
结果变成了这样:
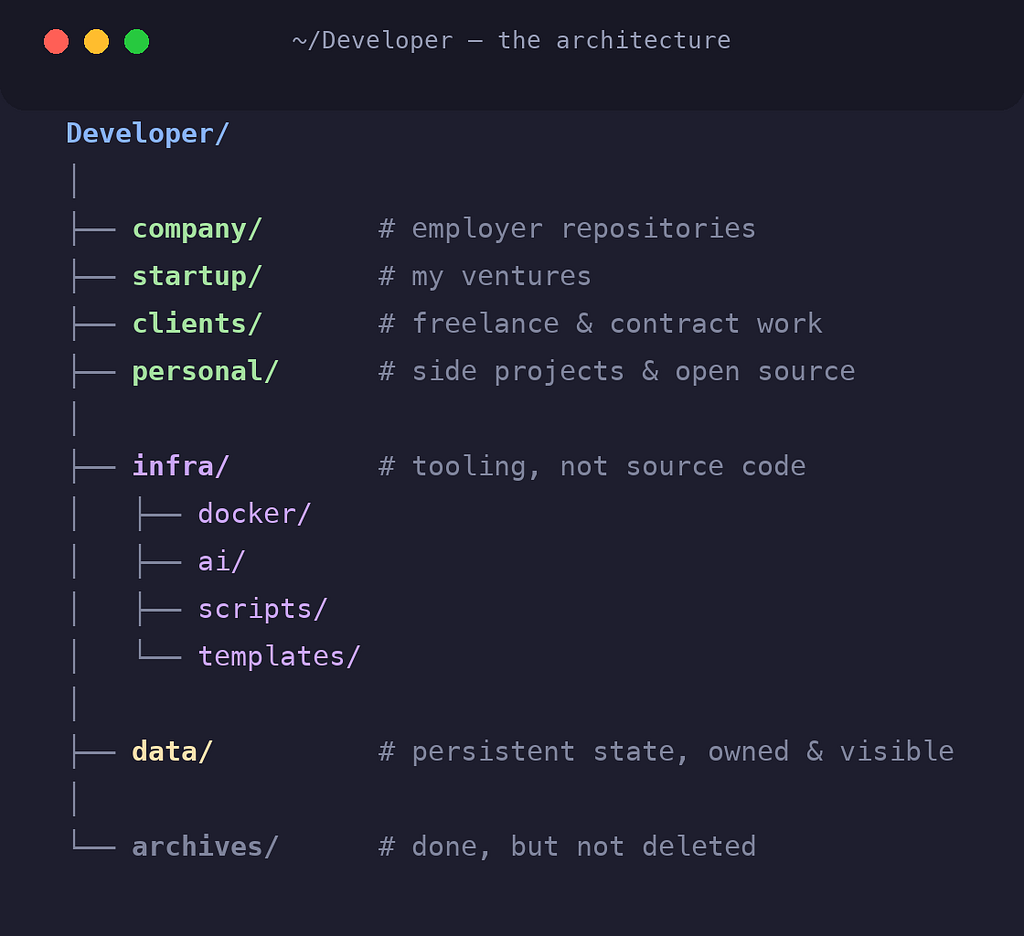
简单。可预测。可扩展。
🧱 源代码不是基础设施
我见过开发者犯的最大错误之一,就是把源代码和基础设施混在一起。
仓库应该包含:
- 业务逻辑
- 应用代码
- 测试
- 文档
它们不应该变成这些东西的垃圾场:
- 本地脚本
- Docker 实验
- 数据库存储
- AI 工具
- 特定于某台机器的配置
这就是为什么我引入了一个专门的基础设施层:
infra/
├── docker/
├── ai/
├── scripts/
└── templates/
基础设施的演进独立于应用程序。把两者分开,能让仓库保持干净和专注。
🐳 简化了一切的那条 Docker 规则
我想要一个 Docker 优先的开发环境。但不是每个仓库都应该被一视同仁地对待。
我最终定下的规则出奇地简单。
✅ 如果我可以修改这个仓库
1 Project = 1 Containerized Development Environment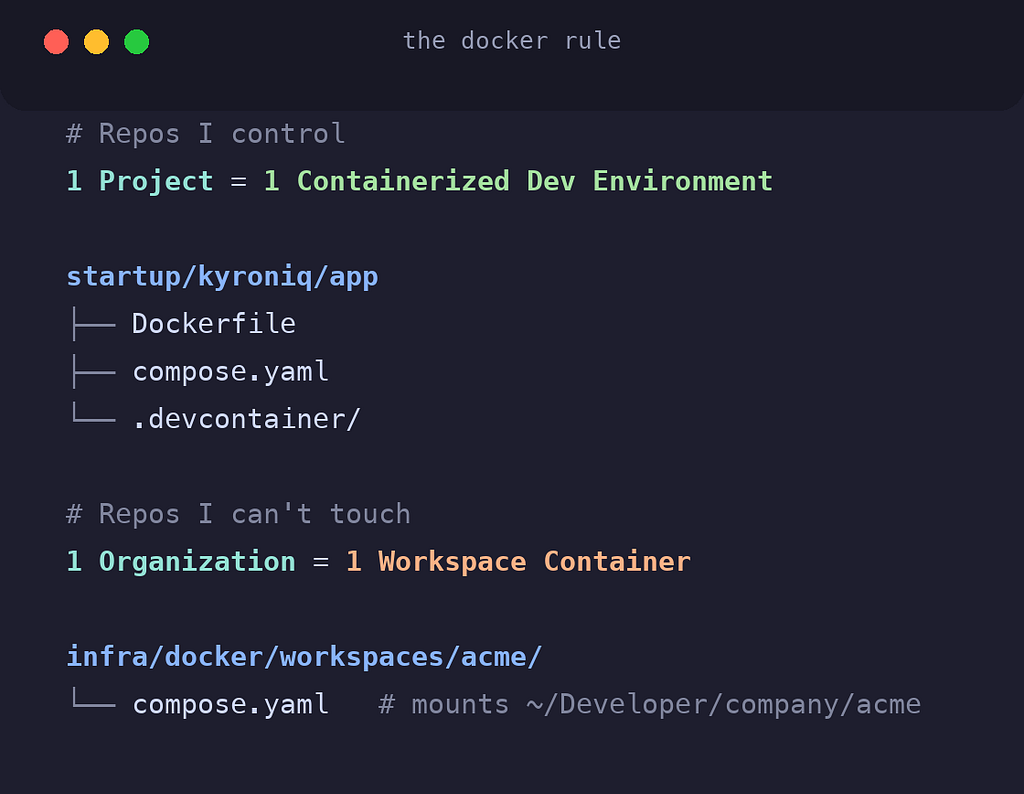
每个项目都拥有自己隔离的环境。
好处包括:
- 依赖隔离
- 可复现性
- 更简单的上手流程
- 与 CI/CD 对齐
- 更好的 AI 工具支持
项目变得自给自足。如果明天有人克隆它,他们拿到的会是完全一样的环境。
🔒 如果我不能修改这个仓库
1 Organization = 1 Workspace Container这对公司仓库尤其有用。
我不会往我控制不了的仓库里加 Docker 文件,而是创建一个外部的工作区容器:
infra/docker/workspaces/acme/这个工作区会挂载属于那个组织的每一个仓库:
volumes:
  - ~/Developer/company/acme:/workspace
这让我能保持 Docker 优先的工作流,同时又不用碰公司自己拥有的代码。
这是个很小的区别,但它消除了大量的摩擦。
💾 为什么我要把数据从其他一切中分离出来
这大概是最重要的一个架构决定。
大多数开发者要么:
- 把数据存在仓库里,或者
- 完全依赖 Docker 管理的数据卷。
这两种方式我都不喜欢。我创建了一个专门的数据层:
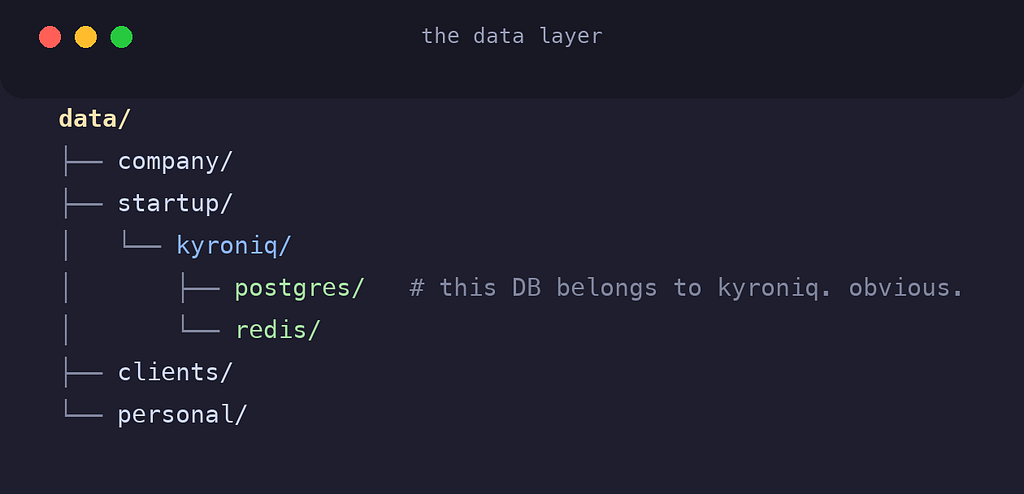
这种结构让所有权一目了然。我立刻就能知道:
- 哪个项目拥有这份数据
- 哪个数据库属于哪个应用
- 什么可以归档
- 什么需要备份
这些好处相当可观:
- 更干净的仓库
- 更简单的备份
- 更简单的迁移
- 更快的 Git 操作
- 对存储用量更好的可见性
最重要的是:
我永远知道我的数据在哪儿。
🤖 为 AI 原生的未来搭建架构
我们写软件的方式正在改变。AI 工具正在变成开发环境本身的一部分:
- Claude Code
- Codex
- Gemini CLI
- 本地模型
- 未来的自主代理
大多数开发者仍然把这些当成项目级别的工具。
我决定把它们当成基础设施:
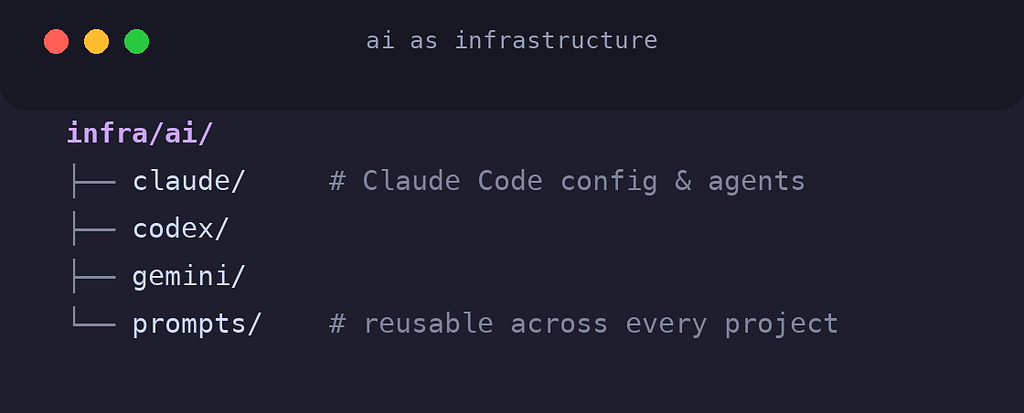
这样就创造出了一个可以跨每个项目复用的 AI 层。
随着工具不断演进,我的仓库始终保持干净。AI 技术栈独立于应用程序本身而变化。
这种分离在接下来这几年只会变得越来越有价值。
⚡ 最大的生产力提升不是 Docker
也不是 AI,也不是自动化。
是降低了心智负担。
当每个项目都遵循一个可预测的结构:
company/
startup/
clients/
personal/
我不再问这些问题:
- 我把这个仓库克隆到哪儿了?
- 这个数据库属于哪个项目?
- 这个代码库归哪家公司所有?
- Docker 配置在哪儿?
- 这个能不能安全归档?
答案是显而易见的。
而这种一致性会不断复利。每一次上下文切换都变得更快。每一个新项目都变得更容易上手。每一个未来的决策都变得更简单。
📦 机器迁移变得无聊起来
大多数开发者不会去想迁移这件事,直到他们买了台新笔记本。
然后痛苦开始了:Docker 数据卷、配置文件、脚本、数据库、环境变量。没人记得一切都放在哪儿。
我的目标很简单:
如果我的机器今天就报废,我应该能从单独一个目录把一切重建出来。
所有重要的东西都放在:
Developer/仓库、基础设施、持久化数据。就这些。
开发环境因此变得可迁移。
而可迁移性,是你能投资的、最被低估的生产力功能之一。
🎯 真正的道理
文件夹结构本身不是重点。它背后的思维方式才是。
优秀的工程师不只是架构应用程序。他们架构系统。
你的工作站是一个系统。你的开发工作流是一个系统。你的生产力是一个系统。
你对设计这些系统越用心,花在跟它们较劲上的精力就越少,而你能用来解决真正工程问题的精力就越多。
一个设计良好的开发环境不会让你一夜之间变成更好的开发者。
但经过成千上万个小时的工作之后,它会悄悄地把摩擦从你碰过的每一个项目里移除。
这才是真正的生产力提升所在。
💬 你的开发工作区长什么样?
我一直很好奇其他工程师是怎么组织自己的环境的,尤其是现在 Docker、Dev Containers 和 AI 辅助开发正在成为标准工作流的一部分。
工具生态每年都在变化。
一个好的工作区架构,应该扛得住所有这些变化。