Ваш код, не узкое место. Узкое место, ваше окружение.
Большинство разработчиков часами спорят о:
- React против Vue
- Docker против Podman
- Claude Code против Cursor
- PostgreSQL против MySQL
При этом та вещь, с которой они взаимодействуют каждый божий день, почти не получает внимания:
Их рабочее пространство разработчика.
Несколько месяцев назад мне понадобилось вернуться к проекту, к которому я не притрагивался почти год.
Я помнил кое-что:
- Использовался PostgreSQL.
- Где-то был замешан Redis.
- Приложение работало в Docker.
- В процессе разработки участвовали AI-инструменты.
Чего я не помнил, так это где вообще всё это лежит.
Код не был проблемой. Архитектура не была проблемой.
Проблемой было моё окружение разработки.
Где-то между работой в стартапах, побочными проектами, экспериментами с AI-инструментами и ведением клиентских заказов моя машина превратилась в набор несвязанных проектов, продублированных окружений и забытой инфраструктуры.
Каждый новый проект решал сиюминутную проблему. Ни один не решил долгосрочную:
Как организовать окружение разработки так, чтобы оно масштабировалось вместе с карьерой?
Этот вопрос заставил меня полностью пересмотреть структуру своего рабочего пространства.
🚨 Проблема, которую игнорирует большинство разработчиков
В начале карьеры организация проектов обычно выглядит примерно так:
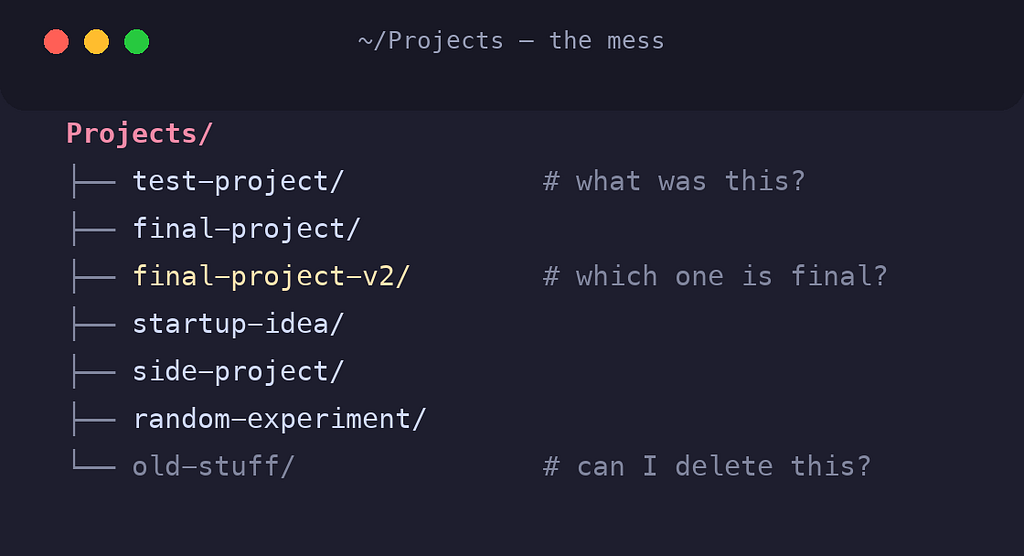
Сначала это работает.
Потом начинается жизнь.
Вы устраиваетесь в компанию. Начинаете фрилансить. Запускаете стартап. Строите открытые проекты. Начинаете экспериментировать с AI-инструментами. Начинаете запускать PostgreSQL, Redis, Docker-контейнеры и локальные сервисы.
Проблема не в количестве проектов. Проблема в отсутствии структуры.
По мере роста числа репозиториев растёт и ментальная нагрузка:
- Где вообще этот репозиторий?
- Какой инстанс PostgreSQL принадлежит какому проекту?
- Где конфигурация Docker?
- Можно ли безопасно удалить эту папку?
- Почему у меня установлены три разные версии Node.js?
Эти вопросы звучат мелко. Но за годы разработки они складываются в колоссальную потерю продуктивности.
🧠 Мышление системного инженера
Прорыв случился, когда я перестал относиться к своей рабочей машине как к набору проектов, и начал относиться к ней как к программной системе.
Я задал себе один вопрос:
Как бы выглядело моё окружение разработки, если бы мне пришлось управлять сотнями репозиториев в следующие десять лет?
Этот вопрос полностью изменил мой подход.
Вместо оптимизации под сегодняшние проекты я стал оптимизировать под:
- Нескольких работодателей
- Стартап-начинания
- Клиентские заказы
- Вклад в open-source
- Разработку Docker-first
- Разработку с помощью AI
- Лёгкий перенос на новую машину
- Долгосрочную поддерживаемость
В итоге получилось вот что:
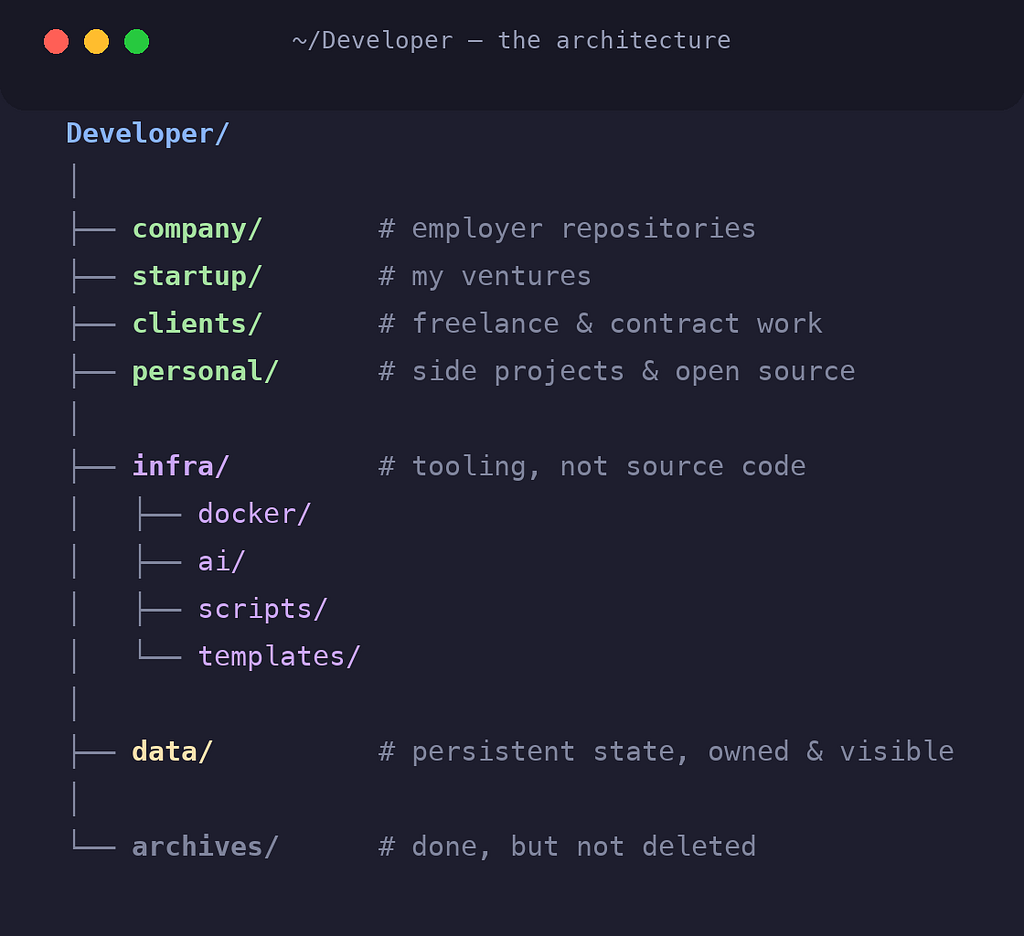
Просто. Предсказуемо. Масштабируемо.
🧱 Исходный код, не инфраструктура
Одна из главных ошибок, которые я вижу у разработчиков, смешивание исходного кода с инфраструктурой.
Репозитории должны содержать:
- Бизнес-логику
- Код приложения
- Тесты
- Документацию
Они не должны превращаться в свалку для:
- Локальных скриптов
- Экспериментов с Docker
- Хранилища баз данных
- AI-инструментов
- Конфигурации, специфичной для машины
Поэтому я ввёл выделенный слой инфраструктуры:
infra/
├── docker/
├── ai/
├── scripts/
└── templates/
Инфраструктура развивается независимо от приложений. Их разделение сохраняет репозитории чистыми и сфокусированными.
🐳 Правило Docker, которое всё упростило
Я хотел окружение разработки Docker-first. Но не с каждым репозиторием следует обращаться одинаково.
Правило, к которому я пришёл, удивительно простое.
✅ Если я могу изменять репозиторий
1 проект = 1 контейнеризированное окружение разработки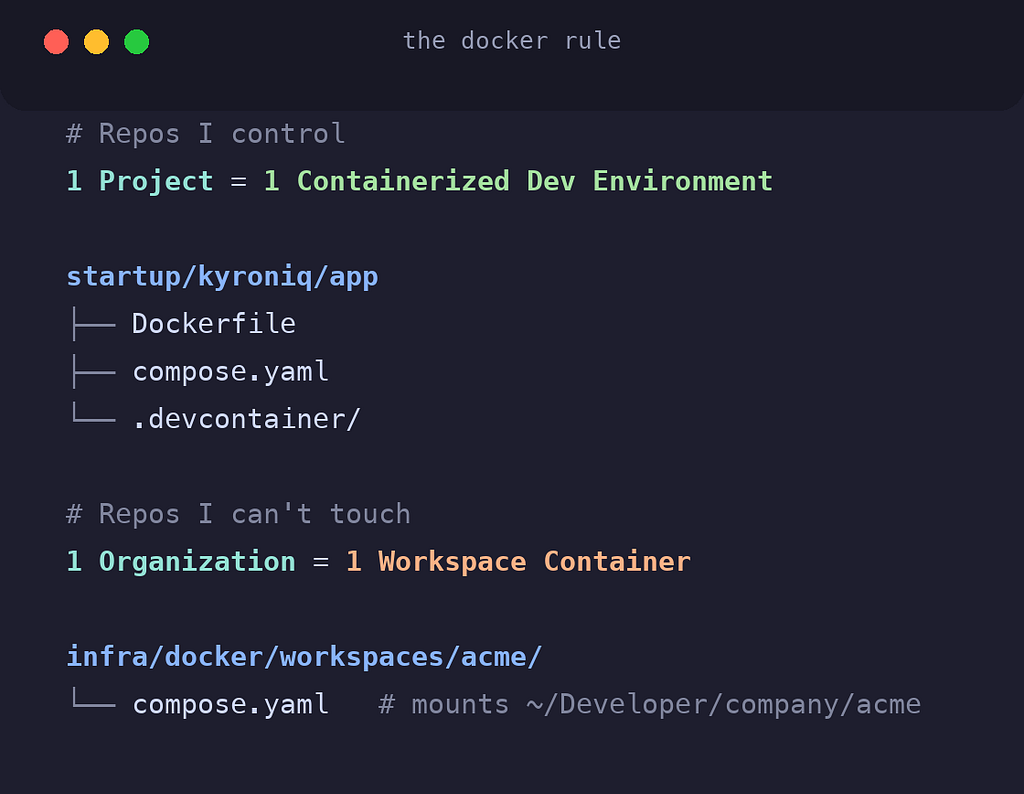
Каждый проект получает своё изолированное окружение.
Преимущества:
- Изоляция зависимостей
- Воспроизводимость
- Более простой онбординг
- Согласованность с CI/CD
- Лучшая поддержка AI-инструментов
Проект становится самодостаточным. Если кто-то склонирует его завтра, он получит точно такое же окружение.
🔒 Если я не могу изменять репозиторий
1 организация = 1 контейнер рабочего пространстваЭто особенно полезно для корпоративных репозиториев.
Вместо добавления Docker-файлов в репозитории, которые я не контролирую, я создаю внешний контейнер рабочего пространства:
infra/docker/workspaces/acme/Это рабочее пространство монтирует каждый репозиторий, принадлежащий этой организации:
volumes:
  - ~/Developer/company/acme:/workspace
Это позволяет мне держать workflow Docker-first, не трогая код, принадлежащий компании.
Разница небольшая, но она устраняет массу трения.
💾 Почему я отделяю данные от всего остального
Это было, пожалуй, самое важное архитектурное решение.
Большинство разработчиков либо:
- Хранят данные внутри репозиториев, либо
- Полностью полагаются на тома, управляемые Docker.
Мне не понравился ни один из подходов. Вместо этого я создал выделенный слой данных:
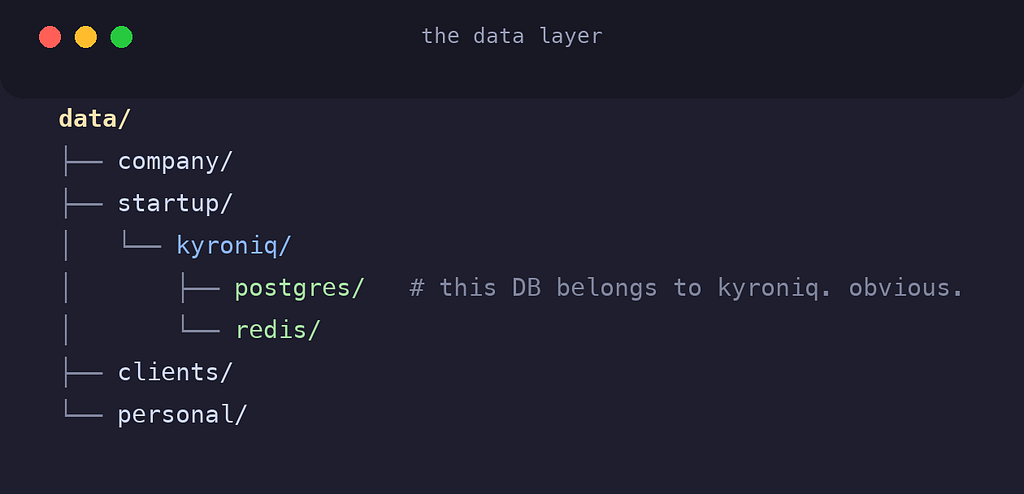
Эта структура делает владение очевидным. Я сразу знаю:
- Какому проекту принадлежат данные
- Какая база данных относится к какому приложению
- Что можно заархивировать
- Что нуждается в бэкапе
Преимущества значительны:
- Более чистые репозитории
- Более простые бэкапы
- Более простая миграция
- Более быстрые операции Git
- Лучшая видимость использования хранилища
Самое важное:
Я всегда знаю, где живут мои данные.
🤖 Строим для AI-native будущего
То, как мы пишем ПО, меняется. AI-инструменты сами становятся частью окружения разработки:
- Claude Code
- Codex
- Gemini CLI
- Локальные модели
- Будущие автономные агенты
Большинство разработчиков всё ещё относятся к ним как к инструментам уровня проекта.
Я решил относиться к ним как к инфраструктуре:
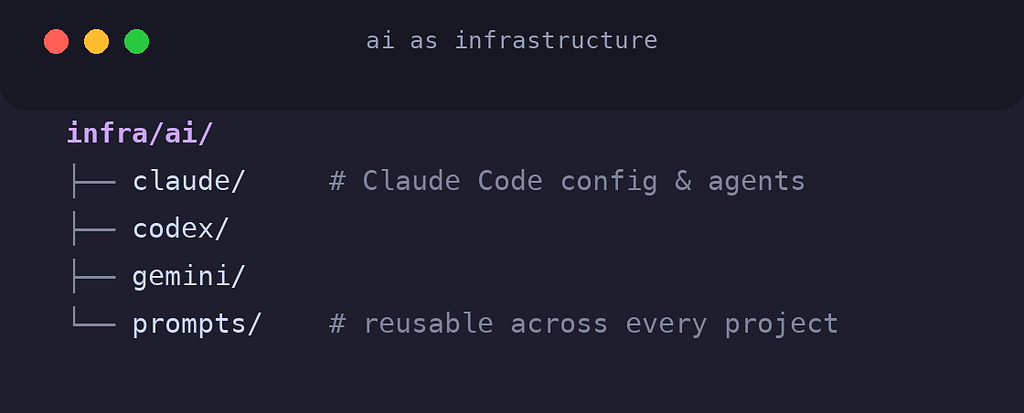
Это создаёт переиспользуемый слой AI, который работает во всех проектах сразу.
По мере развития инструментов мои репозитории остаются чистыми. AI-стек меняется независимо от самих приложений.
Это разделение будет становиться только ценнее в ближайшие несколько лет.
⚡ Самый большой прирост продуктивности был не от Docker
Не от AI. Не от автоматизации.
Это было снижение когнитивной нагрузки.
Когда каждый проект следует предсказуемой структуре:
company/
startup/
clients/
personal/
Я больше не задаю себе вопросы вроде:
- Куда я склонировал этот репозиторий?
- Какая база данных принадлежит этому проекту?
- Какой компании принадлежит эта кодовая база?
- Где конфигурация Docker?
- Можно ли безопасно это заархивировать?
Ответ очевиден.
И эта согласованность накапливается. Каждое переключение контекста становится быстрее. Каждый новый проект, проще онбордить. Каждое будущее решение, проще принять.
📦 Перенос на новую машину становится скучным
Большинство разработчиков не думают о переносе, пока не купят новый ноутбук.
Тогда и начинается боль: тома Docker. Файлы конфигурации. Скрипты. Базы данных. Переменные окружения. Никто не помнит, где что лежит.
Моя цель была простой:
Если моя машина умрёт сегодня, я должен суметь восстановить всё из одной-единственной директории.
Всё важное живёт под:
Developer/Репозитории. Инфраструктура. Постоянные данные. Вот и всё.
Окружение разработки становится переносимым.
А переносимость, одна из самых недооценённых функций продуктивности, в которую можно инвестировать.
🎯 Настоящий урок
Важна не сама структура папок. Важен образ мышления за ней.
Хорошие инженеры не просто проектируют приложения. Они проектируют системы.
Ваша рабочая машина, это система. Ваш процесс разработки, это система. Ваша продуктивность, это система.
Чем осознаннее вы проектируете эти системы, тем меньше энергии тратите на борьбу с ними, и тем больше энергии остаётся на решение настоящих инженерных задач.
Хорошо спроектированное окружение разработки не сделает вас лучшим разработчиком за одну ночь.
Но за тысячи часов работы оно тихо убирает трение из каждого проекта, к которому вы прикасаетесь.
Именно оттуда берётся настоящий прирост продуктивности.
💬 Как выглядит ваше рабочее пространство разработчика?
Мне всегда интересно, как другие инженеры организуют свои окружения, особенно теперь, когда Docker, Dev Containers и разработка с помощью AI становятся частью стандартного workflow.
Ландшафт инструментов меняется каждый год.
Хорошая архитектура рабочего пространства должна пережить их все.