Seu código não é o gargalo. Seu ambiente é.
A maioria dos desenvolvedores passa horas debatendo:
- React vs Vue
- Docker vs Podman
- Claude Code vs Cursor
- PostgreSQL vs MySQL
Enquanto isso, a coisa com que interagem todos os dias recebe quase nenhuma atenção:
O workspace de desenvolvimento deles.
Alguns meses atrás, precisei voltar a um projeto que eu não tocava havia quase um ano.
Eu me lembrava de algumas coisas:
- Usava PostgreSQL.
- Redis estava envolvido de alguma forma.
- A aplicação rodava em Docker.
- Havia ferramentas de IA no fluxo de trabalho.
O que eu não lembrava era onde qualquer coisa disso vivia.
O código não era o problema. A arquitetura não era o problema.
Meu ambiente de desenvolvimento era.
Em algum ponto entre trabalhar em startups, construir projetos paralelos, experimentar ferramentas de IA e gerenciar trabalho de clientes, minha máquina tinha virado uma coleção de projetos desconectados, ambientes duplicados e infraestrutura esquecida.
Todo projeto novo resolvia um problema imediato. Nenhum deles resolvia o problema de longo prazo:
Como você organiza um ambiente de desenvolvimento que escala junto com sua carreira?
Essa pergunta me levou a redesenhar completamente como estruturo meu workspace.
🚨 O Problema Que a Maioria dos Desenvolvedores Ignora
No início da carreira, a organização de projetos geralmente se parece com isto:
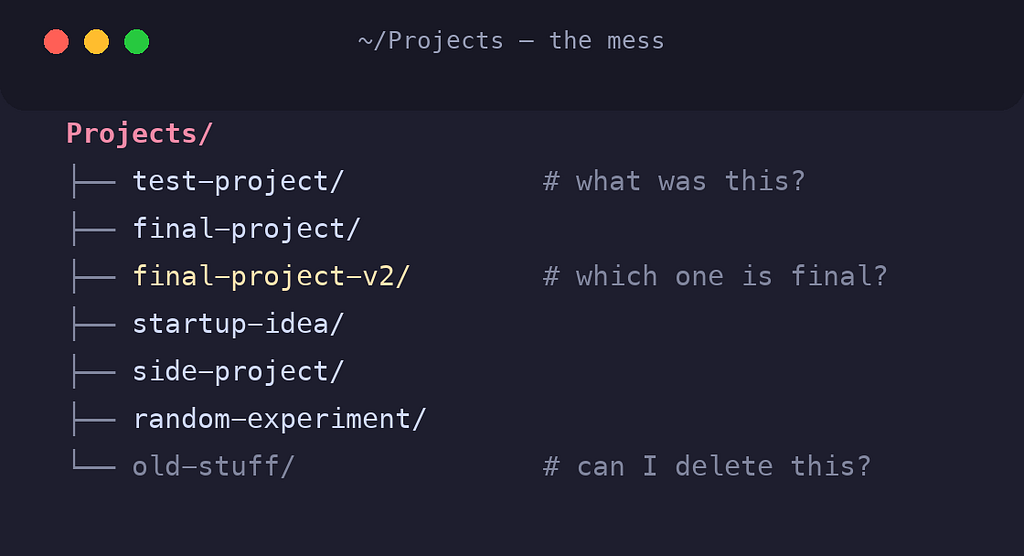
No começo, funciona.
Depois a vida acontece.
Você entra numa empresa. Começa a fazer freelance. Lança uma startup. Constrói projetos open-source. Começa a experimentar ferramentas de IA. Passa a rodar PostgreSQL, Redis, containers Docker e serviços locais.
O número de projetos não é o problema. A falta de estrutura é.
Conforme os repositórios se multiplicam, também se multiplica a carga mental:
- Onde está aquele repositório?
- Qual instância de PostgreSQL pertence a qual projeto?
- Onde está a configuração do Docker?
- Posso deletar essa pasta com segurança?
- Por que tenho três versões diferentes de Node.js instaladas?
Essas perguntas parecem pequenas. Mas ao longo de anos de desenvolvimento, elas se acumulam num enorme dreno de produtividade.
🧠 Pensando Como um Engenheiro de Sistemas
O ponto de virada veio quando parei de tratar minha estação de trabalho como uma coleção de projetos, e passei a tratá-la como um sistema de software.
Fiz a mim mesmo uma pergunta:
Como seria meu ambiente de desenvolvimento se eu tivesse que gerenciar centenas de repositórios ao longo da próxima década?
Essa pergunta mudou completamente minha abordagem.
Em vez de otimizar para os projetos de hoje, otimizei para:
- Múltiplos empregadores
- Empreendimentos de startup
- Trabalho de clientes
- Contribuições open-source
- Desenvolvimento Docker-first
- Desenvolvimento assistido por IA
- Migração de máquina fácil
- Manutenibilidade de longo prazo
O resultado virou isto:
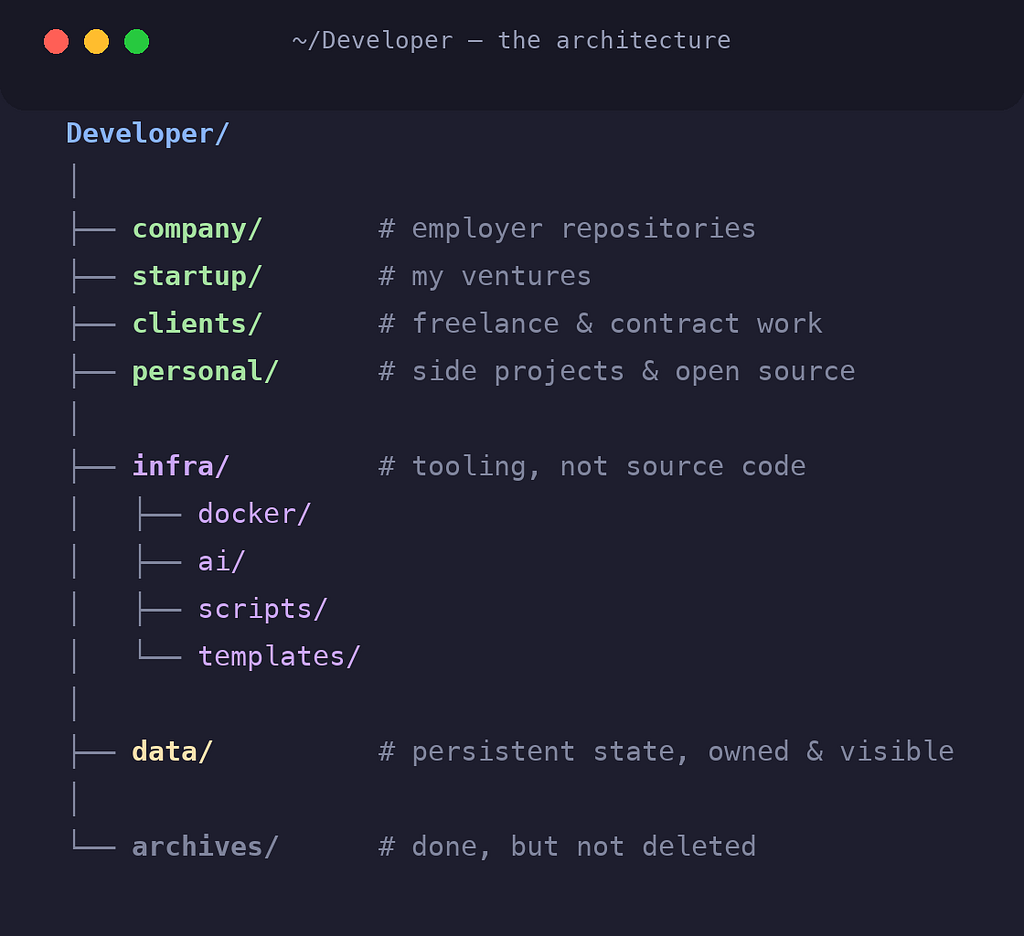
Simples. Previsível. Escalável.
🧱 Código-Fonte Não É Infraestrutura
Um dos maiores erros que vejo desenvolvedores cometerem é misturar código-fonte com infraestrutura.
Repositórios deveriam conter:
- Lógica de negócio
- Código de aplicação
- Testes
- Documentação
Eles não deveriam virar depósito de:
- Scripts locais
- Experimentos com Docker
- Armazenamento de banco de dados
- Ferramentas de IA
- Configuração específica da máquina
Por isso introduzi uma camada de infraestrutura dedicada:
infra/
├── docker/
├── ai/
├── scripts/
└── templates/
A infraestrutura evolui independentemente das aplicações. Separá-las mantém os repositórios limpos e focados.
🐳 A Regra do Docker Que Simplificou Tudo
Eu queria um ambiente de desenvolvimento Docker-first. Mas nem todo repositório deveria ser tratado da mesma forma.
A regra a que cheguei é surpreendentemente simples.
✅ Se eu posso modificar o repositório
1 Projeto = 1 Ambiente de Desenvolvimento Containerizado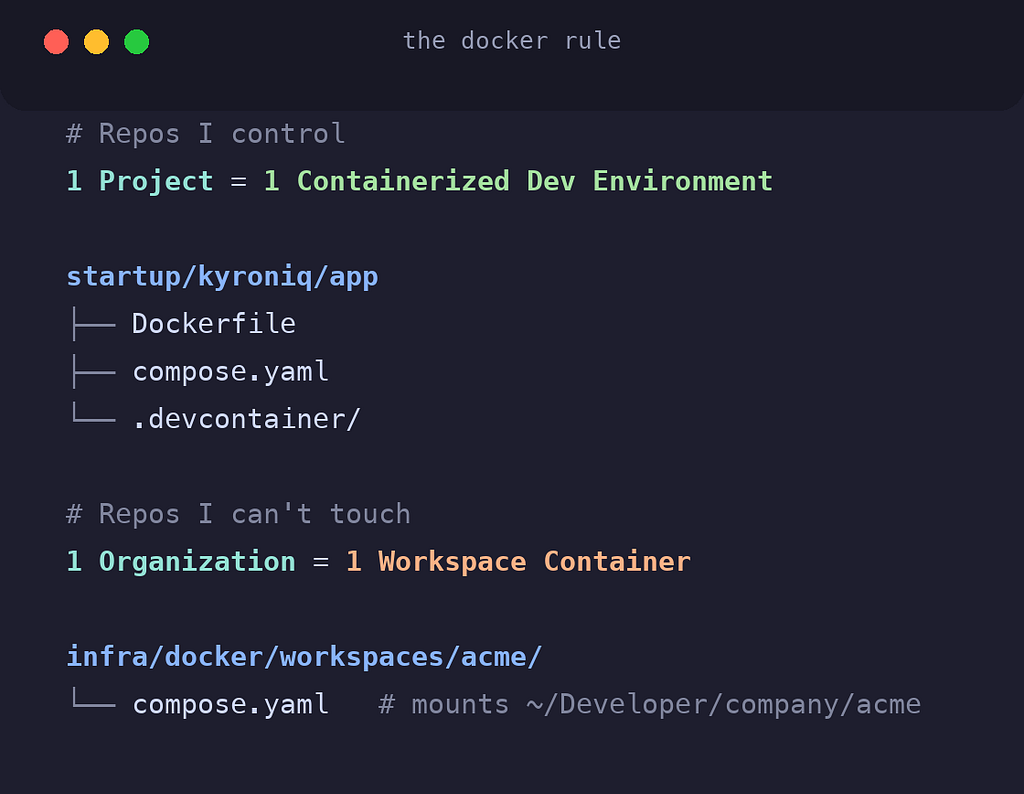
Todo projeto ganha seu próprio ambiente isolado.
Os benefícios:
- Isolamento de dependências
- Reprodutibilidade
- Onboarding mais fácil
- Alinhamento com CI/CD
- Melhor suporte a ferramentas de IA
O projeto se torna autocontido. Se alguém clonar amanhã, recebe exatamente o mesmo ambiente.
🔒 Se eu não posso modificar o repositório
1 Organização = 1 Container de WorkspaceIsso é especialmente útil para repositórios de empresas.
Em vez de adicionar arquivos Docker a repositórios que não controlo, crio um container de workspace externo:
infra/docker/workspaces/acme/O workspace monta cada repositório pertencente àquela organização:
volumes:
  - ~/Developer/company/acme:/workspace
Isso me permite manter um fluxo de trabalho Docker-first sem tocar em código pertencente à empresa.
É uma distinção pequena, mas elimina bastante atrito.
💾 Por Que Separo Dados de Tudo o Mais
Essa foi provavelmente a decisão arquitetural mais importante.
A maioria dos desenvolvedores ou:
- Guarda dados dentro dos repositórios, ou
- Depende inteiramente de volumes gerenciados pelo Docker.
Eu não gostei de nenhuma das duas abordagens. Em vez disso, criei uma camada de dados dedicada:
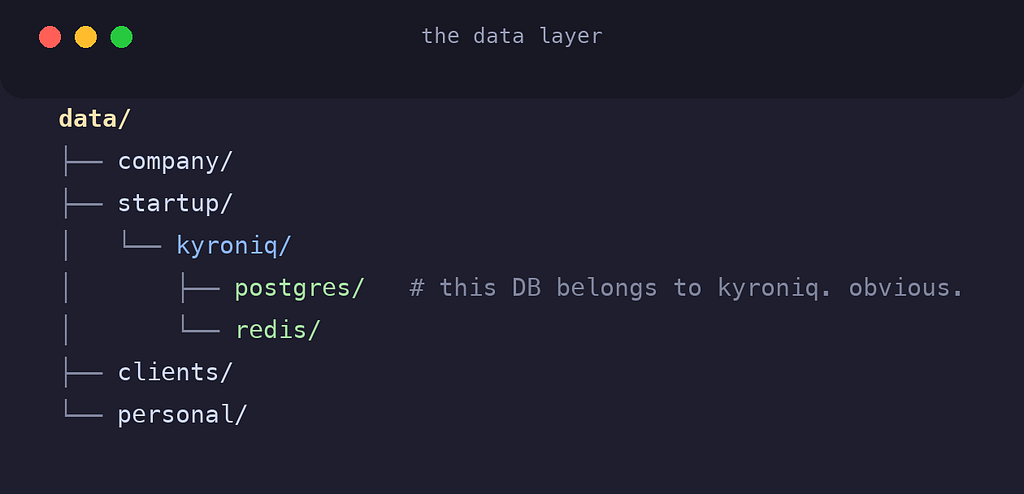
Essa estrutura torna a propriedade óbvia. Sei imediatamente:
- Qual projeto é dono de quais dados
- Qual banco de dados pertence a qual aplicação
- O que pode ser arquivado
- O que precisa de backup
Os benefícios são significativos:
- Repositórios mais limpos
- Backups mais fáceis
- Migração mais simples
- Operações de Git mais rápidas
- Melhor visibilidade sobre o uso de armazenamento
Mais importante:
Eu sempre sei onde meus dados vivem.
🤖 Construindo Para um Futuro Nativo em IA
A forma como escrevemos software está mudando. Ferramentas de IA estão se tornando parte do próprio ambiente de desenvolvimento:
- Claude Code
- Codex
- Gemini CLI
- Modelos locais
- Futuros agentes autônomos
A maioria dos desenvolvedores ainda trata essas ferramentas no nível do projeto.
Decidi tratá-las como infraestrutura:
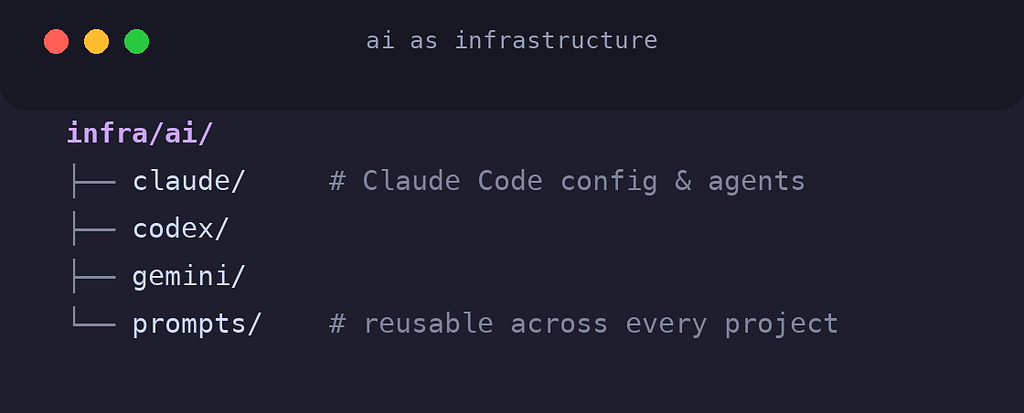
Isso cria uma camada de IA reutilizável que funciona em todos os projetos.
Conforme as ferramentas evoluem, meus repositórios permanecem limpos. O stack de IA muda independentemente das próprias aplicações.
Essa separação vai se tornar cada vez mais valiosa nos próximos anos.
⚡ O Maior Ganho de Produtividade Não Foi o Docker
Não foi IA. Não foi automação.
Foi reduzir a carga cognitiva.
Quando todo projeto segue uma estrutura previsível:
company/
startup/
clients/
personal/
Eu não faço mais perguntas como:
- Onde cloniei esse repositório?
- Qual banco de dados pertence a este projeto?
- Qual empresa é dona dessa base de código?
- Onde está a configuração do Docker?
- Posso arquivar isso com segurança?
A resposta é óbvia.
E essa consistência se acumula. Toda troca de contexto fica mais rápida. Todo projeto novo fica mais fácil de assimilar. Toda decisão futura fica mais simples.
📦 Migração de Máquina Vira Algo Chato
A maioria dos desenvolvedores não pensa em migração até comprar um notebook novo.
Aí a dor começa: volumes do Docker. Arquivos de configuração. Scripts. Bancos de dados. Variáveis de ambiente. Ninguém lembra onde está cada coisa.
Meu objetivo era simples:
Se minha máquina morresse hoje, eu deveria conseguir reconstruir tudo a partir de um único diretório.
Tudo o que importa vive em:
Developer/Repositórios. Infraestrutura. Dados persistentes. Só isso.
O ambiente de desenvolvimento se torna portátil.
E portabilidade é uma das funcionalidades de produtividade mais subestimadas em que você pode investir.
🎯 A Lição de Verdade
A estrutura de pastas em si não é a parte importante. A mentalidade por trás dela é.
Bons engenheiros não arquitetam só aplicações. Eles arquitetam sistemas.
Sua estação de trabalho é um sistema. Seu fluxo de desenvolvimento é um sistema. Sua produtividade é um sistema.
Quanto mais intencional você for ao projetar esses sistemas, menos energia gasta lutando contra eles, e mais energia sobra para resolver problemas de engenharia de verdade.
Um ambiente de desenvolvimento bem projetado não vai te transformar num desenvolvedor melhor da noite para o dia.
Mas ao longo de milhares de horas de trabalho, ele remove atrito silenciosamente de todo projeto que você toca.
É daí que vêm os ganhos de produtividade de verdade.
💬 Como é o seu workspace de desenvolvimento?
Sempre tenho curiosidade de como outros engenheiros organizam seus ambientes, especialmente agora que Docker, Dev Containers e desenvolvimento assistido por IA estão se tornando parte do fluxo de trabalho padrão.
O cenário de ferramentas muda a cada ano.
Uma boa arquitetura de workspace deveria sobreviver a todas elas.