Il tuo codice non è il collo di bottiglia. Il tuo ambiente lo è.
La maggior parte degli sviluppatori passa ore a dibattere:
- React contro Vue
- Docker contro Podman
- Claude Code contro Cursor
- PostgreSQL contro MySQL
Nel frattempo, la cosa con cui interagiscono ogni singolo giorno riceve quasi nessuna attenzione:
Il proprio workspace di sviluppo.
Qualche mese fa, ho dovuto riprendere in mano un progetto che non toccavo da quasi un anno.
Mi ricordavo alcune cose:
- Usava PostgreSQL.
- Redis era coinvolto in qualche modo.
- L'applicazione girava in Docker.
- C'erano strumenti AI nel flusso di lavoro.
Quello che non ricordavo era dove vivesse tutto questo.
Il codice non era il problema. L'architettura non era il problema.
Era il mio ambiente di sviluppo.
Da qualche parte tra il lavorare in startup, costruire side project, sperimentare con strumenti AI e gestire lavoro per clienti, la mia macchina si era trasformata in una collezione di progetti scollegati, ambienti duplicati e infrastruttura dimenticata.
Ogni nuovo progetto risolveva un problema immediato. Nessuno risolveva quello a lungo termine:
Come si organizza un ambiente di sviluppo che scala con la propria carriera?
Quella domanda mi ha portato a riprogettare completamente come struttavo il mio workspace.
🚨 Il problema che la maggior parte degli sviluppatori ignora
All'inizio della carriera, l'organizzazione dei progetti di solito assomiglia a questo:
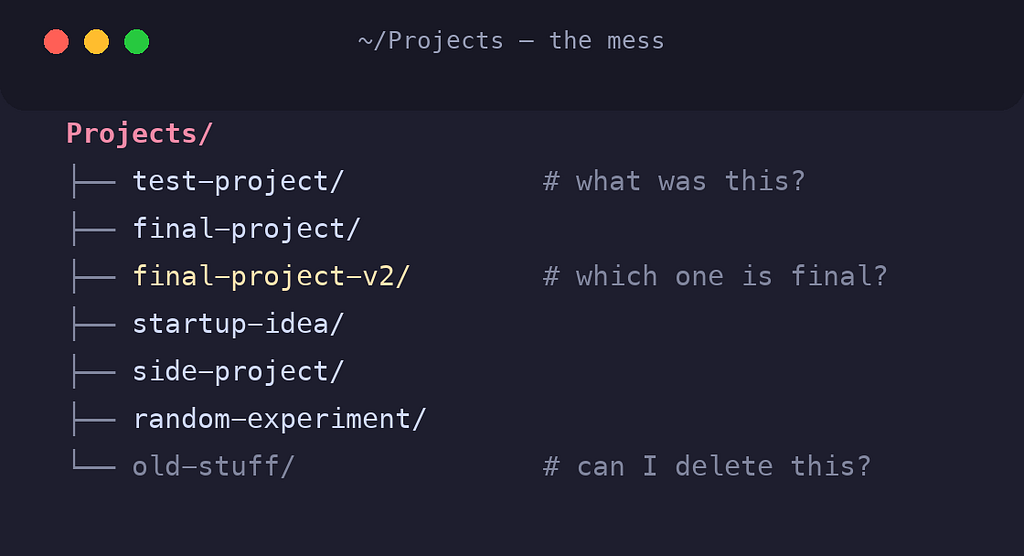
All'inizio, funziona.
Poi arriva la vita.
Entri in un'azienda. Inizi a fare freelance. Lanci una startup. Costruisci progetti open-source. Inizi a sperimentare con strumenti AI. Inizi a far girare PostgreSQL, Redis, container Docker e servizi locali.
Il numero di progetti non è il problema. La mancanza di struttura lo è.
Man mano che i repository si moltiplicano, si moltiplica anche il sovraccarico mentale:
- Dov'è quel repository?
- Quale istanza di PostgreSQL appartiene a quale progetto?
- Dov'è la configurazione Docker?
- Posso cancellare questa cartella senza rischi?
- Perché ho tre versioni diverse di Node.js installate?
Queste domande sembrano piccole. Ma su anni di sviluppo, si accumulano in un drenaggio massiccio di produttività.
🧠 Pensare come un systems engineer
La svolta è arrivata quando ho smesso di trattare la mia postazione di lavoro come una collezione di progetti, e ho iniziato a trattarla come un sistema software.
Mi sono fatto una domanda:
Come sarebbe il mio ambiente di sviluppo se dovessi gestire centinaia di repository nel prossimo decennio?
Quella domanda ha cambiato completamente il mio approccio.
Invece di ottimizzare per i progetti di oggi, ho ottimizzato per:
- Più datori di lavoro
- Iniziative startup
- Lavoro per clienti
- Contributi open-source
- Sviluppo Docker-first
- Sviluppo assistito da AI
- Migrazione facile della macchina
- Manutenibilità a lungo termine
Il risultato è diventato questo:
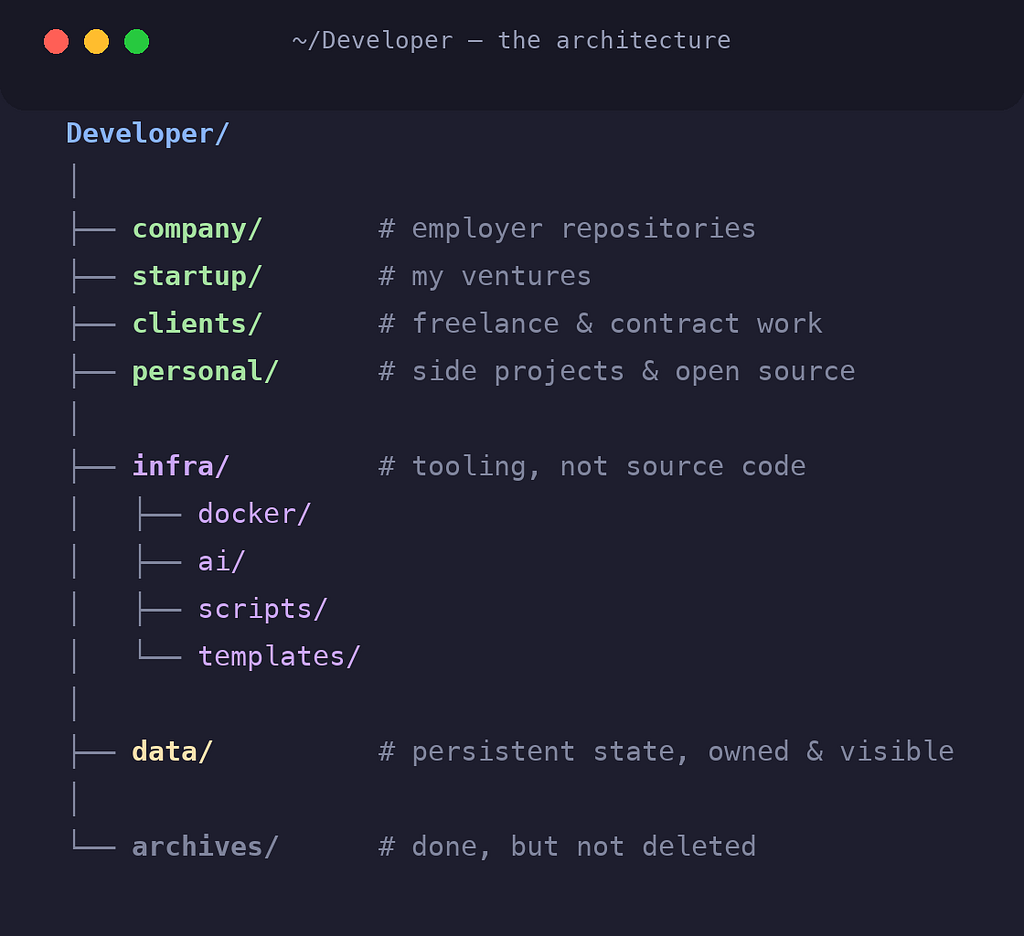
Semplice. Prevedibile. Scalabile.
🧱 Il codice sorgente non è infrastruttura
Uno degli errori più grandi che vedo fare agli sviluppatori è mescolare il codice sorgente con l'infrastruttura.
I repository dovrebbero contenere:
- Logica di business
- Codice dell'applicazione
- Test
- Documentazione
Non dovrebbero mai diventare discariche per:
- Script locali
- Esperimenti Docker
- Storage del database
- Strumenti AI
- Configurazione specifica della macchina
Ecco perché ho introdotto un livello di infrastruttura dedicato:
infra/
├── docker/
├── ai/
├── scripts/
└── templates/
L'infrastruttura evolve indipendentemente dalle applicazioni. Separarle mantiene i repository puliti e mirati.
🐳 La regola Docker che ha semplificato tutto
Volevo un ambiente di sviluppo Docker-first. Ma non ogni repository dovrebbe essere trattato allo stesso modo.
La regola a cui sono arrivato è sorprendentemente semplice.
✅ Se posso modificare il repository
1 Progetto = 1 Ambiente di sviluppo containerizzato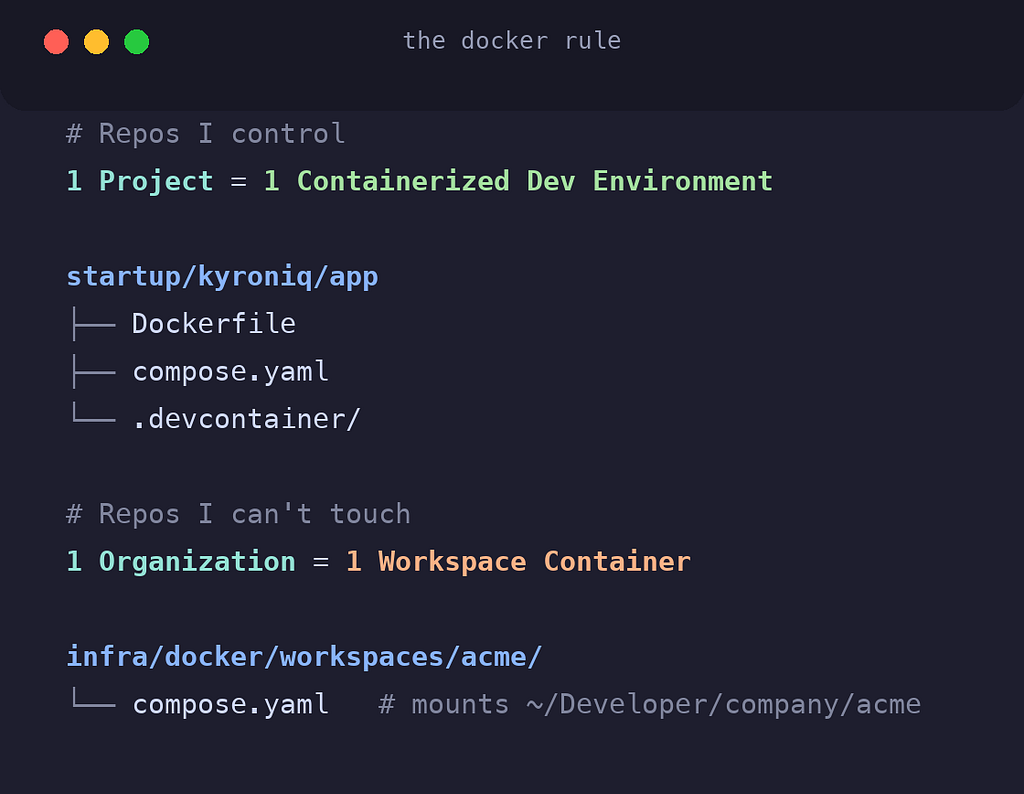
Ogni progetto ottiene il proprio ambiente isolato.
I benefici:
- Isolamento delle dipendenze
- Riproducibilità
- Onboarding più facile
- Allineamento con CI/CD
- Supporto migliore per gli strumenti AI
Il progetto diventa autosufficiente. Se qualcuno lo clona domani, ottiene esattamente lo stesso ambiente.
🔒 Se non posso modificare il repository
1 Organizzazione = 1 Container workspaceQuesto è particolarmente utile per i repository aziendali.
Invece di aggiungere file Docker a repository che non controllo, creo un container workspace esterno:
infra/docker/workspaces/acme/Il workspace monta ogni repository appartenente a quell'organizzazione:
volumes:
  - ~/Developer/company/acme:/workspace
Questo mi permette di mantenere un flusso di lavoro Docker-first senza toccare codice di proprietà aziendale.
È una distinzione piccola, ma elimina molto attrito.
💾 Perché separo i dati da tutto il resto
Questa è stata probabilmente la decisione architetturale più importante.
La maggior parte degli sviluppatori o:
- Salva i dati dentro i repository, oppure
- Si affida interamente ai volumi gestiti da Docker.
Nessuno dei due approcci mi convinceva. Invece, ho creato un livello dati dedicato:
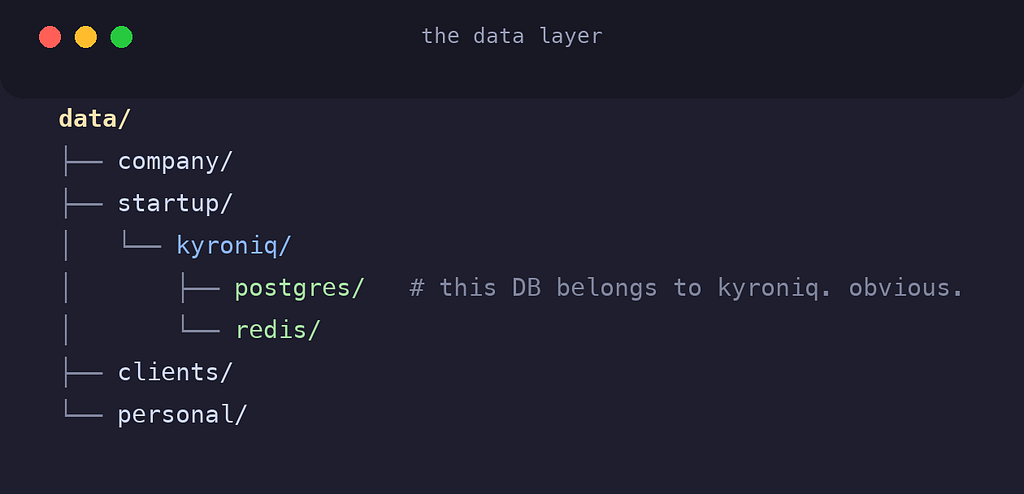
Questa struttura rende ovvia la proprietà. So immediatamente:
- Quale progetto possiede quali dati
- Quale database appartiene a quale applicazione
- Cosa può essere archiviato
- Cosa ha bisogno di backup
I benefici sono significativi:
- Repository più puliti
- Backup più facili
- Migrazione più semplice
- Operazioni Git più veloci
- Migliore visibilità sull'uso dello storage
Ma soprattutto:
So sempre dove vivono i miei dati.
🤖 Costruire per un futuro AI-native
Il modo in cui scriviamo software sta cambiando. Gli strumenti AI stanno diventando parte dell'ambiente di sviluppo stesso:
- Claude Code
- Codex
- Gemini CLI
- Modelli locali
- Futuri agenti autonomi
La maggior parte degli sviluppatori li tratta ancora come strumenti a livello di progetto.
Ho deciso di trattarli come infrastruttura:
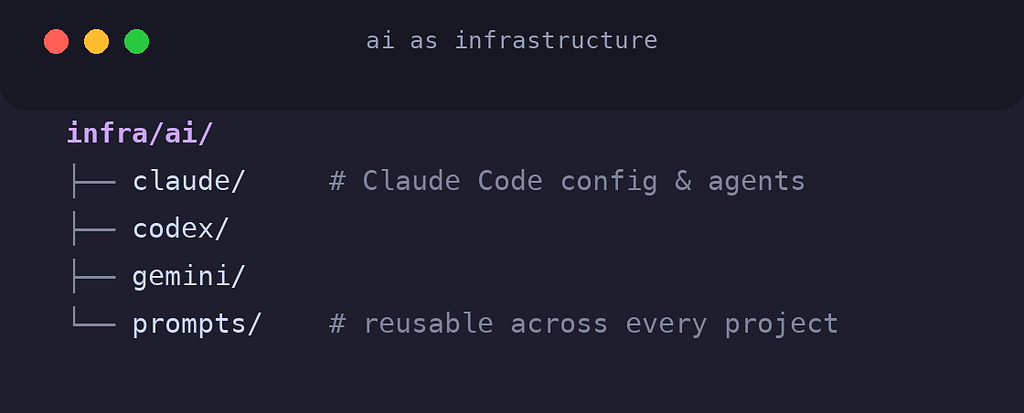
Questo crea un livello AI riutilizzabile che funziona su ogni progetto.
Man mano che gli strumenti evolvono, i miei repository restano puliti. Lo stack AI cambia indipendentemente dalle applicazioni stesse.
Quella separazione diventerà sempre più preziosa nei prossimi anni.
⚡ Il guadagno di produttività più grande non era Docker
Non era l'AI. Non era l'automazione.
Era ridurre il carico cognitivo.
Quando ogni progetto segue una struttura prevedibile:
company/
startup/
clients/
personal/
Non mi faccio più domande come:
- Dove ho clonato questo repository?
- Quale database appartiene a questo progetto?
- Quale azienda possiede questa codebase?
- Dov'è la configurazione Docker?
- Posso archiviarlo senza rischi?
La risposta è ovvia.
E quella coerenza si accumula. Ogni cambio di contesto diventa più veloce. Ogni nuovo progetto diventa più facile da avviare. Ogni decisione futura diventa più semplice.
📦 La migrazione di macchina diventa noiosa
La maggior parte degli sviluppatori non pensa alla migrazione finché non compra un nuovo laptop.
Poi inizia il dolore: volumi Docker. File di configurazione. Script. Database. Variabili d'ambiente. Nessuno si ricorda dove vive tutto.
Il mio obiettivo era semplice:
Se la mia macchina morisse oggi, dovrei poter ricostruire tutto da un'unica directory.
Tutto ciò che è importante vive sotto:
Developer/Repository. Infrastruttura. Dati persistenti. Tutto qui.
L'ambiente di sviluppo diventa portabile.
E la portabilità è una delle funzionalità di produttività più sottovalutate su cui puoi investire.
🎯 La lezione vera
La struttura di cartelle in sé non è la parte importante. Lo è la mentalità dietro di essa.
I bravi ingegneri non progettano solo applicazioni. Progettano sistemi.
La tua postazione di lavoro è un sistema. Il tuo flusso di lavoro di sviluppo è un sistema. La tua produttività è un sistema.
Più sei intenzionale nel progettare quei sistemi, meno energia spendi a combatterli, e più energia hai per risolvere i problemi ingegneristici veri.
Un ambiente di sviluppo ben progettato non ti renderà uno sviluppatore migliore da un giorno all'altro.
Ma su migliaia di ore di lavoro, elimina silenziosamente attrito da ogni progetto che tocchi.
È lì che arrivano i veri guadagni di produttività.
💬 Com'è fatto il tuo workspace di sviluppo?
Sono sempre curioso di sapere come altri ingegneri organizzano i loro ambienti, specialmente ora che Docker, Dev Container e sviluppo assistito da AI stanno diventando parte del flusso di lavoro standard.
Il panorama degli strumenti cambia ogni anno.
Una buona architettura di workspace dovrebbe sopravvivere a tutti loro.